




Metryki help desku dają konkretny sposób na zrozumienie, jak zespół wsparcia radzi sobie na co dzień. Koncentrują się na mierzalnych elementach pracy wsparcia IT, takich jak liczba napływających zgłoszeń, czas potrzebny na odpowiedź, poziom zadowolenia użytkowników po interakcji czy koszt obsługi każdego zgłoszenia.
Dobry zestaw metryk pomaga monitorować kondycję operacji wsparcia bez zagłębiania się w techniczne szczegóły. Możesz szybko zauważyć trendy w liczbie zgłoszeń, zidentyfikować opóźnienia w czasie pierwszej odpowiedzi lub zobaczyć, gdzie spada jakość usług.
Poniżej znajdziesz 19 metryk help desku i service desku, które warto mierzyć w 2026 roku, wraz z formułami, wartościami referencyjnymi oraz wskazówkami, jak interpretować każdą z nich bez wyciągania mylących wniosków.
Najważniejsze informacje
Metryki help desku to mierzalne wskaźniki służące do oceny wydajności i skuteczności zespołów wsparcia. Obejmują dane operacyjne, takie jak liczba zgłoszeń, czas pierwszej odpowiedzi, wyniki CSAT i koszt jednego zgłoszenia. Pomiary te pomagają zrozumieć wzorce obciążenia pracą, jakość usług i efektywność procesów wsparcia.
Zapewniają także oparty na faktach obraz tego, jak zgłoszenia przechodzą przez proces wsparcia. Przy regularnym monitorowaniu metryk widoczne stają się wzorce napływającego zapotrzebowania, opóźnienia w odpowiedziach lub rozwiązaniach oraz wahania opinii użytkowników.
Choć mają pewne podobieństwa, metryki help desku i kluczowe wskaźniki efektywności (KPI) mają różne zastosowania i cele.
Metryka raportuje; KPI ocenia. Wszystkie KPI wykorzystują metryki, ale nie wszystkie metryki są KPI.
Na przykład FRT i TTR są metrykami operacyjnymi, ale gdy wyznaczysz cel taki jak „odpowiadać średnio w ciągu 15 minut” lub „rozwiązywać standardowe incydenty w ciągu ośmiu godzin”, stają się częścią KPI służącego do monitorowania efektywności. Te same metryki mogą również wspierać KPI skoncentrowany na satysfakcji, gdy połączysz je z trendami CSAT, ponieważ powolne odpowiedzi lub rozwiązania często korelują z niższymi ocenami użytkowników.
Monitorowanie właściwych KPI service desku daje zespołom IT podstawę do podejmowania decyzji, które w przeciwnym razie opierałyby się na intuicji. W szczególności wspierają one:
Monitorowanie metryk bez powiązania ich z celem jest przydatne diagnostycznie, ale kolejnym krokiem jest przełożenie ich na działania operacyjne. Sam cel „poprawić satysfakcję klientów” nie wystarczy. Istotne jest to, czy CSAT regularnie spada po określonym typie zgłoszenia albo czy zgodność z SLA pogarsza się w konkretnym dziale — ponieważ to właśnie takie sygnały prowadzą do konkretnych decyzji: zmiany SLA, przeglądu obsady w danym obszarze lub usunięcia wąskiego gardła w kolejce.
Wykorzystywanie metryk help desku do definiowania i dostosowywania KPI jest dobrą praktyką service desku; w ten sposób napędza się ciągłe doskonalenie.
Aby zachować przejrzystość modelu, metryki w tym artykule zostały pogrupowane w cztery kategorie.
Nie musisz mierzyć wszystkiego, aby utrzymać operacje wsparcia pod kontrolą. Celem jest wybór metryk odzwierciedlających sposób pracy zespołu, ich konsekwentne monitorowanie oraz dostosowywanie zestawu wraz z rozwojem service desku.
Ta lista pomaga porównywać wskaźniki należące do tej samej kategorii — produktywności, jakości, wydajności lub wpływu finansowego — aby zdecydować, które z nich odpowiadają rezultatom, które chcesz poprawić.
Metryki produktywności mierzą relację między obciążeniem pracą a zdolnością zespołu do przetwarzania zgłoszeń w stałym tempie. Pomagają oceniać przepustowość, identyfikować punkty przeciążenia w kolejce oraz określać, kiedy potrzebne są zmiany w obsadzie, harmonogramach lub przepływie pracy.
Liczba zgłoszeń to liczba incydentów lub zgłoszeń otrzymanych i obsłużonych przez wsparcie IT w określonym czasie. Mierzy obciążenie pracą i efektywność zespołu obsługi klienta.
Liczbę zgłoszeń można również analizować według kanału (e-mail, portal, telefon, czat), kategorii, priorytetu, usługi, grupy klientów i czasu (godzina/dzień/tydzień). Dzięki temu można wykorzystać tę metrykę do korelowania nagłych wzrostów z wdrożeniami nowych wersji, wprowadzania zmian w konfiguracji, ustalania progów alarmowych dla nietypowych wzrostów i nie tylko.
Liczba zaległych zgłoszeń mierzy całkowitą liczbę zgłoszeń, których agenci nie rozwiązali w danym okresie. Dostarcza informacji o obciążeniu pracą personelu wsparcia IT, efektywności systemu wsparcia i satysfakcji klientów. Analizowanie trendów wraz z szablonem ankiety satysfakcji klienta pomaga zespołom ustalać priorytety, ograniczać opóźnienia, poprawiać jakość rozwiązań, lepiej przydzielać zasoby oraz dostosowywać wyniki wsparcia do zmieniających się oczekiwań i rezultatów użytkowników.
Duża liczba zaległych zgłoszeń może wskazywać, że zespół wsparcia IT jest przeciążony, co prowadzi do wydłużenia czasu rozwiązywania problemów i niskiej satysfakcji klientów.
Wykorzystanie agentów mierzy czas, jaki agent wsparcia IT poświęca na działania związane ze wsparciem, w porównaniu z całkowitym dostępnym czasem pracy.
Chociaż jest to głównie prosty współczynnik, wynik może wprowadzać w błąd, jeśli nie określisz, co obejmuje „czas wsparcia”. Dwa service deski korzystające z tej samej formuły mogą uzyskać bardzo różne wskaźniki wykorzystania w zależności od sposobu rejestrowania pracy. Dlatego ta metryka wymaga większego kontekstu niż samo obliczenie.
Nie cała praca związana z obsługą incydentów jest widoczna jako bezpośredni czas pracy nad zgłoszeniem. Analiza, działania następcze, wewnętrzne dyskusje, eskalacje i zadania administracyjne mogą zajmować znaczną część dnia. Jeśli śledzisz wyłącznie czas zarejestrowany bezpośrednio przy zgłoszeniach, wykorzystanie może wydawać się niższe niż rzeczywiste obciążenie. Jeśli natomiast bez rozróżnienia uwzględnisz każdą aktywność, wynik może być sztucznie zawyżony.
Możliwe podejścia do pomiaru obejmują:
Metryki jakości oceniają rezultaty pracy service desku z perspektywy użytkownika. Koncentrują się na spójności, niezawodności i postrzeganej wartości doświadczenia ze wsparciem. Wskaźniki te pomagają zrozumieć, jak skutecznie zespół rozwiązuje problemy, czy poziomy usług spełniają oczekiwania oraz jak użytkownicy oceniają wysiłek potrzebny do uzyskania pomocy. Razem dają realistyczny obraz jakości usług wykraczający poza samą produktywność lub szybkość.
Wskaźnik satysfakcji klienta mierzy poziom zadowolenia klientów z otrzymywanego wsparcia IT. Metrykę CSAT zazwyczaj mierzy się, prosząc klientów o ocenę poziomu zadowolenia z otrzymanego wsparcia IT, zwykle w skali 1–5 lub 1–10.
CSAT jest wyprzedzającym wskaźnikiem jakości doświadczenia i pomaga identyfikować obszary wymagające poprawy. CSAT należy monitorować regularnie, najlepiej po każdej interakcji z klientem.
CSAT odzwierciedla także odczucia dotyczące całego doświadczenia, a nie tylko pracy IT — opóźnienia spowodowane przez inne zespoły, niejasne procesy lub decyzje dotyczące polityk mogą obniżyć ocenę nawet wtedy, gdy agent wykonał swoją pracę prawidłowo.
Net Promoter Score określa prawdopodobieństwo, że klienci polecą firmę lub jej produkty/usługi innym osobom. Jest to powszechnie stosowana metryka, która pomaga organizacjom zrozumieć lojalność i satysfakcję klientów. Ponadto organizacje wykorzystują ją do porównywania wyników różnych produktów lub usług oraz oceny skuteczności zmian wprowadzanych w inicjatywach dotyczących doświadczeń klientów.
Metrykę NPS zazwyczaj mierzy się, zadając klientom jedno pytanie: „W skali od 0 do 10, jak prawdopodobne jest, że polecisz naszą firmę/produkty/usługi znajomemu lub współpracownikowi?”. Na podstawie odpowiedzi klientów klasyfikuje się następnie do trzech kategorii: Promotorzy (9–10), Pasywni (7–8) i Krytycy (0–6).
W przeciwieństwie do CSAT, NPS jest zwykle wysyłany rzadziej i odzwierciedla skumulowane doświadczenia. Użytkownicy interpretują też pytanie w różny sposób w zależności od kultury organizacyjnej, oczekiwań dotyczących usług lub widoczności IT. Niski NPS nie zawsze odzwierciedla niedawne wyniki; może wynikać ze starszych problemów lub szerszego niezadowolenia z technologii w firmie.
Zgodność z Service Level Agreement mierzy stopień, w jakim zespół wsparcia IT realizuje cele i standardy określone w SLA. SLA to formalna umowa między zespołem wsparcia IT a jego klientami, określająca usługi świadczone przez organizację, oczekiwany poziom wsparcia oraz ramy czasowe rozwiązywania problemów.
Nie wszystkie SLA odzwierciedlają rzeczywiste oczekiwania użytkowników. Cele ustawione zbyt nisko zawyżają wskaźnik zgodności, natomiast zbyt rygorystyczne prowadzą do ciągłego ich niespełniania, co nie odzwierciedla rzeczywistych wyników. Praktycznym podejściem jest przegląd wzorców dotyczących typów zgłoszeń, routingu i odpowiedzialności za kolejki, a następnie stopniowe korygowanie progów zamiast gwałtownego przechodzenia do nowych wartości. Pomocne jest również porównanie SLA z wewnętrznymi OLA, aby zespoły wsparcia nie odpowiadały za zobowiązania, których zespoły zależne nie są w stanie spełnić.
Klasyfikacja również wymaga krótkiego audytu, ponieważ niespójne kategorie zniekształcają dane dotyczące odpowiedzi i rozwiązania. Krótki cykl kalibracji co kilka miesięcy zwykle wystarcza, aby SLA pozostawały realistyczne, ale nie zbyt łagodne.
Customer Effort Score mierzy, jak łatwo użytkownikowi było rozwiązać problem lub zrealizować zgłoszenie. Koncentruje się na trudnościach występujących w procesie, a nie na końcowym rezultacie.
Metrykę Customer Effort Score zazwyczaj mierzy się, zadając klientom po interakcji z zespołem wsparcia jedno pytanie: „Ile wysiłku trzeba było włożyć w obsługę Twojego zgłoszenia?”. Następnie klienci oceniają swoje doświadczenie w skali od „bardzo łatwe” do „bardzo trudne”.
Na CES duży wpływ ma konstrukcja procesu. Nawet doskonała praca agentów nie zrekompensuje przepływów wymagających wielu akceptacji, wielokrotnego podawania tych samych informacji, długich formularzy lub przekazywania spraw między zespołami. Dzięki temu CES jest czułym wskaźnikiem tarć strukturalnych, a nie indywidualnej wydajności.
Metryki wydajności pokazują, jak szybko i skutecznie zespół wsparcia obsługuje pracę. Pomagają zrozumieć szybkość odpowiedzi, wzorce rozwiązywania zgłoszeń i zachowanie obciążenia pracą.
Czas pierwszej odpowiedzi to czas potrzebny zespołowi wsparcia IT na odpowiedź na pierwsze zgłoszenie klienta z prośbą o pomoc. Nie mierzy czasu potrzebnego na rozwiązanie problemu. Jest to kluczowy wskaźnik efektywności używany do oceny szybkości reagowania zespołów wsparcia IT.
Zakresy FRT zależą od kanału (e-mail, czat, portal). Należy przeanalizować naturalne wzorce odpowiedzi i dostosować cel tak, aby odpowiadał rzeczywistym oczekiwaniom bez sztucznego zawyżania. Jeśli zespół zmienia reguły routingu lub przechodzi na nowe kanały, warto ponownie ocenić cel, ponieważ poziom bazowy może się zmienić.
Rozwiązanie przy pierwszym kontakcie oznacza zdolność zespołu wsparcia IT do rozwiązania problemu lub zgłoszenia klienta podczas jego pierwszego kontaktu z zespołem wsparcia, bez konieczności dalszej komunikacji.
Podczas kalibracji celów FCR sprawdź, które kategorie rzeczywiście mogą zostać rozwiązane przy pierwszym kontakcie, i ustal oczekiwania dla poszczególnych kategorii zamiast jednego globalnego celu. Warto również monitorować, czy dążenie do wyższego FCR nie obniża jakości wsparcia; jeśli szybkie rozwiązania powodują wzrost liczby ponownie otwieranych zgłoszeń, cel wymaga korekty.
Czas do rozwiązania mierzy czas potrzebny na pełne rozwiązanie zgłoszenia od momentu jego otwarcia.
Aby obliczyć TTR, odejmij czas, w którym klient zgłosił problem, od czasu jego rozwiązania.
TTR mierzy cały czas potrzebny na rozwiązanie problemu, w tym wszelkie dalsze kontakty lub eskalacje.
TTR znacznie różni się w zależności od rodzaju incydentu, dlatego jeden benchmark często zniekształca obraz wyników. Ustawienie zbyt rygorystycznego globalnego celu wymusza ciągłe wyjątki, natomiast zbyt szeroki cel ukrywa opóźnienia w kategoriach, które naprawdę mają znaczenie. Najbardziej wiarygodnym podejściem jest analiza historycznych czasów rozwiązania według kategorii lub poziomu istotności oraz ustalanie przedziałów odzwierciedlających rzeczywiste zróżnicowanie.
Średni czas obsługi mierzy średni czas potrzebny przedstawicielowi wsparcia IT na obsłużenie zgłoszenia, w tym czas rozmowy z klientem oraz wykonywania powiązanych zadań, takich jak analiza czy dokumentowanie.
Ważne jest równoważenie AHT innymi metrykami, zwłaszcza wskaźnikami jakości wsparcia, takimi jak satysfakcja klientów, oraz traktowanie go jako metryki trendu, a nie sztywnego celu, aby uniknąć zniekształcania zachowań.
Na przykład przedstawiciel wsparcia IT może bardzo szybko obsługiwać zgłoszenia. Jeśli jednak nie zapewnia skutecznych rozwiązań lub klienci nie są zadowoleni z interakcji, sam AHT może nie dawać pełnego obrazu jakości usług wsparcia IT.
Wskaźnik eskalacji to odsetek zgłoszeń eskalowanych do wyższych poziomów wsparcia lub kierownictwa. Mierzy częstotliwość przypadków, których początkowy zespół wsparcia nie jest w stanie rozwiązać i które wymagają dalszej interwencji.
Wskaźnik eskalacji daje wiarygodny obraz tylko wtedy, gdy logika routingu jest stabilna. Każda zmiana zasad triage'u, struktury kolejek lub obowiązków zespołów może z dnia na dzień zmienić wskaźnik, sprawiając, że wyniki wyglądają gorzej lub lepiej bez rzeczywistej zmiany wydajności. Przy dostosowywaniu progów sprawdź, czy eskalacje wynikają z braków kompetencyjnych, nieprawidłowego przypisania kategorii czy restrykcyjnych granic uprawnień. Ustalaj akceptowalne zakresy według kategorii lub poziomu istotności zamiast stosować jedną uniwersalną wartość. Jeśli wskaźnik spada zbyt nisko, sprawdź, czy sprawy nie są zatrzymywane na poziomie 1 tylko po to, by chronić metrykę.
Istotność incydentu mierzy wpływ incydentu IT na działalność, usługi lub klientów organizacji. Klasyfikuje incydenty według poziomu zakłóceń lub wpływu na firmę.
Zazwyczaj wyróżnia się cztery poziomy istotności incydentu:
Aby przypisać incydentowi poziom istotności, należy oprzeć się na jego wpływie i pilności. Można uwzględnić takie czynniki jak liczba dotkniętych użytkowników, krytyczność systemu lub usługi oraz potencjalny wpływ na przychody.
Dane dotyczące istotności są użyteczne tylko wtedy, gdy kategorie są stosowane konsekwentnie. Jeśli progi są niejasne, zawyżanie lub zaniżanie klasyfikacji rozprzestrzenia się w całej kolejce i zniekształca TTR, realizację SLA i alokację zasobów. Okresowy przegląd przykładów dla każdej kategorii pomaga zachować stabilność modelu.
Metryki finansowe pokazują ekonomiczny wpływ funkcjonowania service desku. Pomagają określić koszt obsługi zapotrzebowania, porównywać wyniki wewnętrzne z benchmarkami oraz wspierać decyzje budżetowe związane z personelem, narzędziami i usprawnieniami procesów.
Koszt jednego zgłoszenia to średni koszt rozwiązania zgłoszenia wsparcia IT. Pomaga organizacjom zrozumieć finansowy wpływ procesów wsparcia IT i może wspierać decyzje dotyczące alokacji zasobów i efektywności.
Zespoły decydują, czy uwzględniać koszty pośrednie (szkolenia, subskrypcje oprogramowania, wewnętrzne rozliczenia). Kluczowe jest zachowanie spójnego modelu, aby trendy pozostawały wiarygodne.
Monitorowanie tej metryki w czasie może dostarczyć informacji o skuteczności zmian procesów lub inwestycji technologicznych. Na przykład jeśli zostanie wdrożone nowe narzędzie help desk lub proces, a koszt jednego zgłoszenia z czasem spadnie, można uznać to za oznakę udanej inwestycji.
ROI oznacza Return on Investment i mierzy efektywność inwestycji. Organizacje wykorzystują go do oceny finansowych zwrotów z inwestycji w infrastrukturę IT, oprogramowanie lub inne projekty związane z technologią.
Korzyści mogą być bezpośrednie (mniejsza liczba godzin pracy) lub pośrednie (wyższy FCR ograniczający przestoje biznesowe). Ważne jest wcześniejsze zdefiniowanie korzyści, aby obliczenia ROI nie opierały się po fakcie na założeniach.
Monitorowanie ROI w czasie pozwala firmom określić, czy inwestycja zakończyła się sukcesem i czy uzasadnione są dalsze inwestycje w podobne technologie.
Metryki AI i ograniczania liczby zgłoszeń śledzą, jaka część pracy związanej ze wsparciem zostaje rozwiązana bez udziału agenta — za pośrednictwem samoobsługi, baz wiedzy i wirtualnych agentów. Pokazują, gdzie automatyzacja przejmuje zapotrzebowanie, jak skutecznie użytkownicy samodzielnie rozwiązują problemy oraz które części kolejki nigdy nie trafiają do człowieka. Ponieważ samoobsługa i rozwiązywanie wspomagane przez AI przejmują coraz większą część działań wsparcia, wskaźniki te pokazują, czy zmiana ta zmniejsza obciążenie agentów, czy jedynie przenosi je na późniejsze etapy.
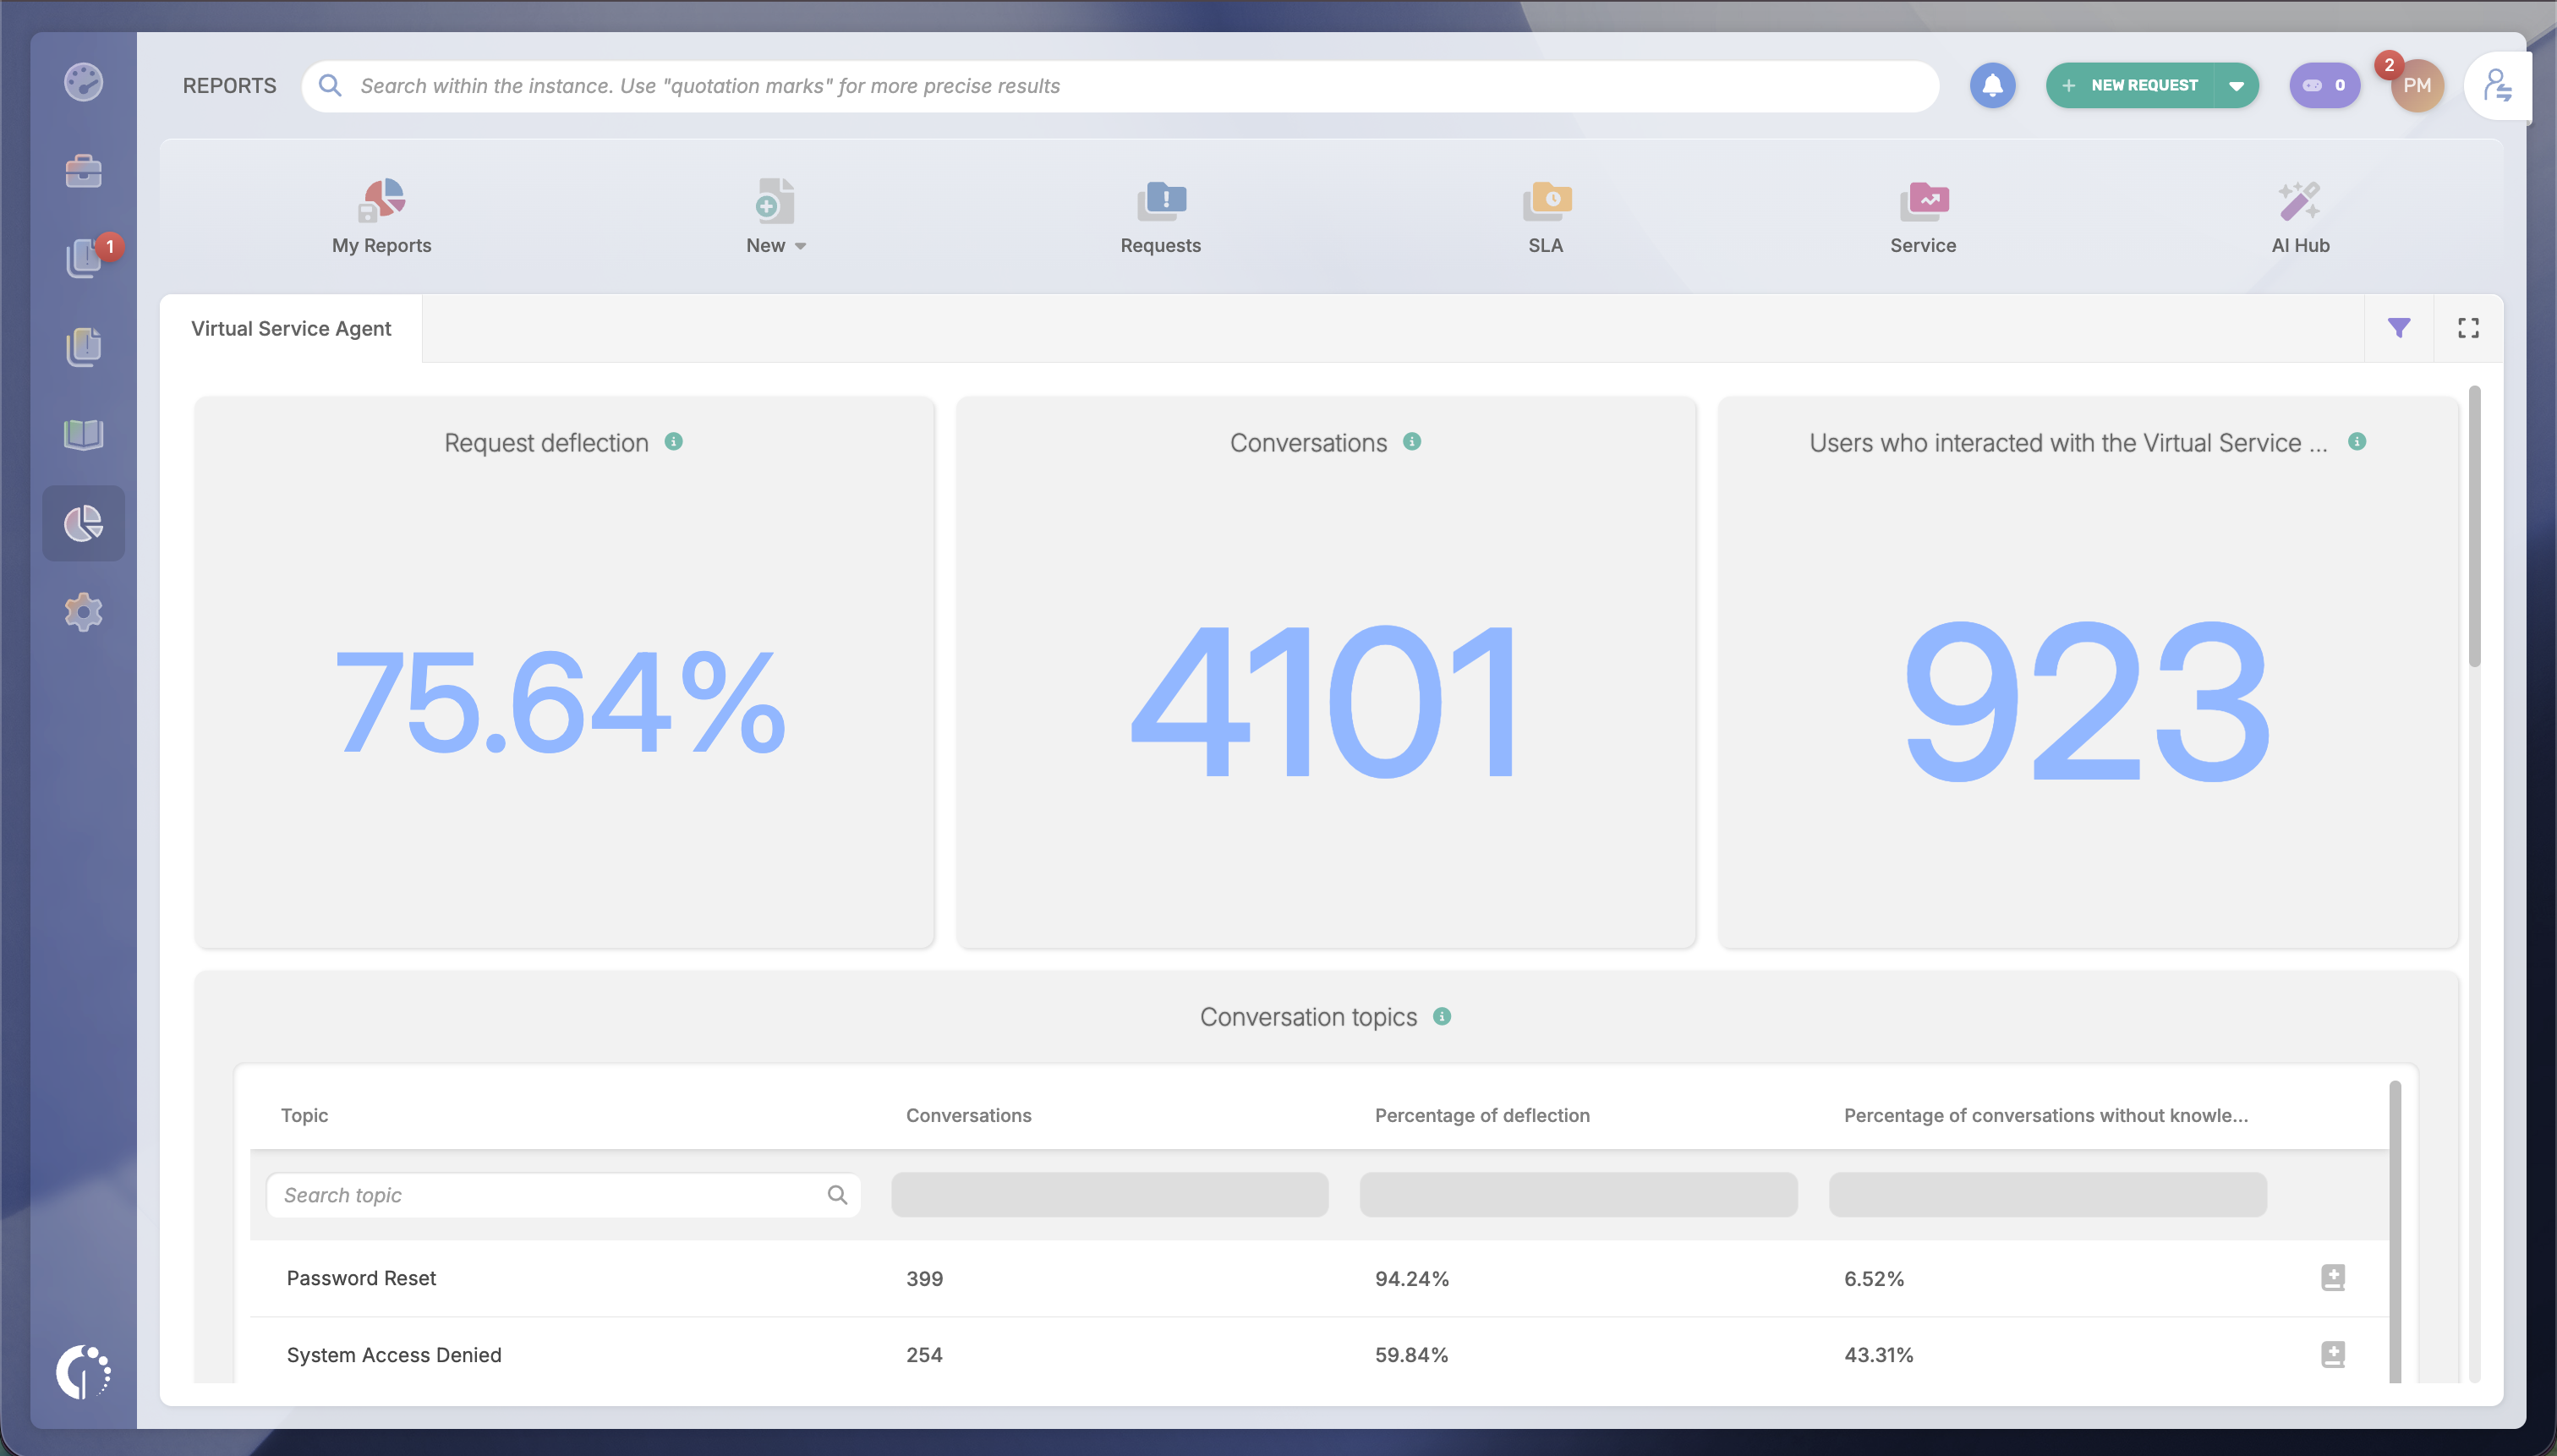
Wskaźnik ograniczania liczby zgłoszeń mierzy odsetek potencjalnych zgłoszeń rozwiązanych w ramach samoobsługi, zanim trafią do agenta. Pokazuje, jak skutecznie bazy wiedzy, portale i wirtualni agenci przejmują zapotrzebowanie, które w przeciwnym razie trafiłoby do kolejki.
Deflection ma znaczenie tylko wtedy, gdy dana interakcja rzeczywiście rozwiązuje problem użytkownika. Wyświetlenie artykułu w bazie wiedzy lub sesja z chatbotem zakończona bez odpowiedzi może zostać zarejestrowana jako deflection, mimo że problem pozostaje nierozwiązany, co zawyża wskaźnik. Połącz deflection z dodatkowym sygnałem — ponownym kontaktem w krótkim czasie, odpowiedzią na pytanie „czy to było pomocne?” lub późniejszym zgłoszeniem dotyczącym tego samego tematu — aby potwierdzić, że uniknięte zgłoszenia rzeczywiście oznaczają rozwiązane problemy.
Wskaźnik skuteczności samoobsługi mierzy odsetek użytkowników, którzy po rozpoczęciu procesu w kanałach samoobsługowych rozwiązują tam swój problem. Pozwala wyodrębnić skuteczność bazy wiedzy i portalu z całego ruchu, pokazując, czy znalezione przez użytkowników treści faktycznie prowadzą do zamknięcia ich sprawy.
Głównym wyzwaniem jest atrybucja. Użytkownik może przeczytać artykuł, opuścić stronę i rozwiązać problem w inny sposób albo przerwać sesję i kilka godzin później otworzyć zgłoszenie. Określenie przedziału czasowego dla rozwiązania oraz powiązanie sesji z późniejszymi kontaktami pomaga utrzymać wiarygodność metryki. Niski wskaźnik skuteczności zwykle wskazuje na braki w treści lub problemy z wyszukiwaniem, dlatego warto segmentować metrykę według tematów, aby znaleźć obszary, w których baza wiedzy osiąga słabsze wyniki i gdzie nowe artykuły pozwoliłyby rozwiązać najwięcej zgłoszeń.
Wskaźnik samodzielnej obsługi przez wirtualnego agenta mierzy odsetek rozmów, które wirtualny agent obsługuje od początku do rozwiązania bez przekazywania ich człowiekowi. Pokazuje, jaką część zapotrzebowania konwersacyjnego przejmuje automatyzacja i gdzie koncentrują się wzorce eskalacji.
Wysoki wskaźnik samodzielnej obsługi ma znaczenie tylko wtedy, gdy rozmowy zakończone bez eskalacji kończą się zadowoleniem użytkownika. Sesje, które utknęły, zapętliły się lub zostały porzucone, mogą zostać policzone jako obsłużone samodzielnie, mimo że użytkownik przechodzi następnie do innego kanału, co ukrywa rzeczywiste obciążenie eskalacjami. Monitoruj ten wskaźnik razem z satysfakcją po rozmowie i wskaźnikami ponownego kontaktu, aby potwierdzić, że jego wzrost rzeczywiście oznacza rozwiązane potrzeby użytkowników.
Wskaźnik automatycznego rozwiązywania mierzy odsetek zgłoszeń rozwiązanych przez zautomatyzowane przepływy pracy bez interwencji agenta po utworzeniu zgłoszenia. Pokazuje wartość automatyzacji zastosowanej po przyjęciu zgłoszenia — routingu, kategoryzacji i zamknięcia obsługiwanych przez reguły lub AI — odróżniając ją od deflection, które odbywa się przed utworzeniem zgłoszenia.
Sposób wyznaczenia granicy między rozwiązaniem wspomaganym automatyzacją a w pełni automatycznym wpływa na tę wartość. Zgłoszenie, które automatyzacja kieruje i wzbogaca o dodatkowe informacje, zanim agent je zamknie, różni się od zgłoszenia zamkniętego od początku do końca bez udziału człowieka. Zdecyduj, które przypadki uznajesz za automatyczne przed raportowaniem wskaźnika, i zachowuj tę definicję w kolejnych okresach, aby trendy były porównywalne. Segmentacja według typu zgłoszenia pokazuje, które kategorie są dobrymi kandydatami do automatyzacji, a które nadal wymagają ludzkiej oceny
Solidny model pomiarowy pomaga zespołom wsparcia IT zrozumieć zapotrzebowanie, jakość usług i koszty operacyjne. Metryki wydajności help desku dają również menedżerom jasny sposób na powiązanie codziennej pracy z szerszymi celami biznesowymi. Gdy są monitorowane konsekwentnie, pomagają podejmować decyzje dotyczące zmian procesów, zatrudnienia i ulepszania usług.
Uporządkowany model sprawia, że metryki pozostają znaczące i zapobiega przekształceniu danych w szum informacyjny. Cztery praktyczne kroki pomogą zbudować solidny proces:
InvGate Service Management ułatwia automatyzację monitorowania metryk i eliminuje konieczność ręcznego raportowania.
Dashboardy w InvGate Service Management konfiguruje się za pomocą elementów obsługiwanych metodą „wskaż i kliknij” oraz „przeciągnij i upuść”.
Ponieważ InvGate Service Management obsługuje wiele help desków i różne poziomy dostępu, warstwa analityczna również je uwzględnia — zapewniając narzędzia raportowe dla koordynatorów i administratorów w poszczególnych obszarach odpowiedzialności. Eliminuje to problem uniwersalnych dashboardów, które pokazują wszystko wszystkim i w rezultacie nie są użyteczne dla nikogo.
Dashboardy można również udostępniać interesariuszom spoza zespołu service desku, zapewniając liderom biznesowym wgląd w czasie rzeczywistym w wyniki usług bez konieczności dostępu do całej platformy.
To właśnie tutaj przejście od metryk do KPI odbywa się na poziomie operacyjnym.
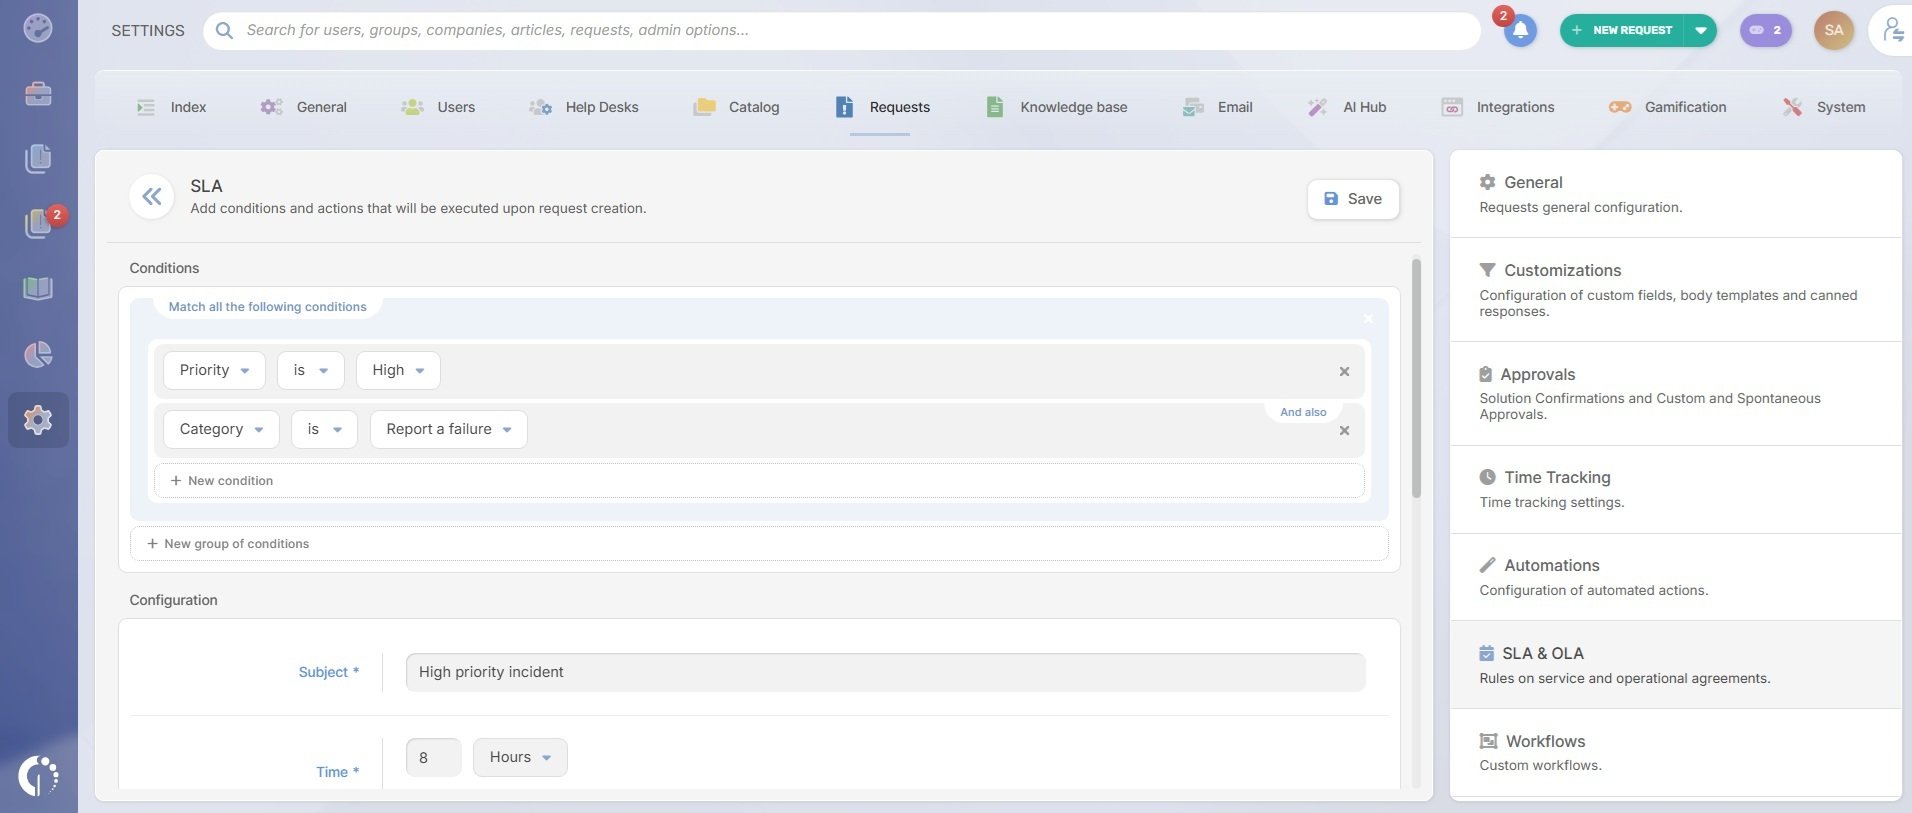
W InvGate Service Management polityki SLA przekształcają metryki takie jak FRT i TTR w cele z logiką alertów. Konfigurujesz próg — na przykład „incydenty P2 muszą zostać rozwiązane w ciągu 8 godzin” — a system monitoruje zgodność w czasie rzeczywistym. Gdy zgłoszenie zbliża się do granicy SLA, platforma może automatycznie wysłać powiadomienie, ponownie przypisać zgłoszenie, eskalować je do kolejnego poziomu lub zmienić jego priorytet.
Raporty można skonfigurować tak, aby zawierały dokładnie te wskaźniki, które mają znaczenie dla Twojego service desku — takie jak FRT, zgodność z SLA czy koszt jednego zgłoszenia.
Aby skonfigurować raport, otwórz Reports → Requests → New report, wybierz metryki, określ zakres dat i zastosuj potrzebne filtry. Po zapisaniu możesz zaplanować automatyczną wysyłkę za pomocą ikony zegara oraz wybrać częstotliwość i odbiorców. Raporty mogą być wysyłane zarówno do użytkowników posiadających licencję, jak i bez licencji, co jest przydatne przy udostępnianiu aktualizacji innym zespołom lub menedżerom.
Dashboardy zapewniają widok wyników w czasie rzeczywistym. Można je dostosować za pomocą widżetów dotyczących zaległych zgłoszeń, eskalacji, czasu odpowiedzi czy metryk finansowych, aby monitorować codzienne operacje. Widoki te pomagają wcześnie wykrywać odchylenia i wspierają szybsze podejmowanie decyzji.
Chcesz zobaczyć, jak wygląda to w praktyce? Poproś o 30-dniowy bezpłatny okres próbny i poznaj InvGate Service Management oraz wszystkie jego możliwości.
Monitorowanie 15 metryk nie oznacza utrzymywania 15 KPI. Rozróżnienie jest istotne: metryki zapewniają możliwość diagnozy; KPI napędzają odpowiedzialność i doskonalenie.
Zalecany zakres dla większości zespołów to 5–7 KPI. Przy mniej niż 5 tracisz pokrycie wszystkich czterech grup. Przy więcej niż 7 trudno jest określić, na które czynniki należy wpływać, gdy wyniki spadają.
Poniżej znajduje się trzyetapowy model przekształcania powyższych metryk w KPI, na podstawie których zespół może podejmować działania.
Zacznij od rezultatu, na który firma musi wpłynąć w bieżącym cyklu, a nie od samych metryk. Przykłady:
Każdy cel jest powiązany z grupą metryk. KPI to te metryki, do których przypisano cel.
KPI bez celu nadal jest tylko metryką. Dla każdego wybranego wskaźnika ustal bieżący poziom wyników (poziom bazowy) oraz poziom, który należy osiągnąć w ramach cyklu przeglądu (cel). Różnica między nimi określa zakres wymaganej poprawy. Wskazówki dotyczące wyznaczania realistycznych celów opartych na SLA i zgodnych z oczekiwaniami biznesowymi znajdziesz w artykule o tworzeniu skutecznych SLA ITSM.
Różne KPI wymagają różnej częstotliwości przeglądu:
Taki rytm zapobiega częstej pułapce przeglądania wszystkiego z taką samą częstotliwością: zarówno przeoczeniu szybko zmieniających się sygnałów (metryk operacyjnych), jak i nadmiernemu reagowaniu na krótkoterminowy szum (metryki strategiczne).
Jakie są najważniejsze metryki help desku?
Najważniejsze metryki dla większości zespołów to FCR (First Contact Resolution), FRT (First Response Time), wskaźnik zgodności z SLA i CSAT. Razem obejmują szybkość, jakość rozwiązania, przestrzeganie zobowiązań dotyczących poziomu usług i postrzeganą przez użytkownika satysfakcję. To, którym z nich należy nadać priorytet jako KPI, zależy od konkretnego celu biznesowego, na który zespół ma wpłynąć w bieżącym cyklu przeglądu — zespół pracujący nad redukcją kosztów będzie inaczej ważył wykorzystanie agentów i koszt jednego zgłoszenia niż zespół skoncentrowany na poprawie doświadczenia użytkownika.
Jaka jest różnica między metrykami help desku a KPI?
Metryka to operacyjny punkt danych: mierzy to, co wydarzyło się w procesie wsparcia — na przykład średni czas do rozwiązania. KPI to metryka powiązana z konkretnym celem i określonym poziomem docelowym — na przykład rozwiązanie 90% incydentów P2 w ciągu 8 godzin. Wszystkie KPI wykorzystują metryki, ale nie wszystkie metryki są KPI. Rozróżnienie ma znaczenie operacyjne: metryki zapewniają pokrycie diagnostyczne w całym service desku; KPI napędzają odpowiedzialność, alerty i cykle doskonalenia.
Jak mierzyć wydajność help desku?
Łącząc metryki z czterech grup: produktywności (liczba zgłoszeń, zaległe zgłoszenia, wykorzystanie agentów), jakości (CSAT, NPS, zgodność z SLA, CES), wydajności (FRT, TTR, FCR, wskaźnik ponownie otwieranych zgłoszeń) i kosztów (koszt jednego zgłoszenia, wskaźnik skuteczności samoobsługi). Pomiar tylko jednej grupy daje niepełny obraz — zespół z niskim TTR, ale wysokim kosztem jednego zgłoszenia i niskim CSAT, nie osiąga dobrych wyników całościowo. Cztery grupy razem zapewniają równowagę potrzebną do podejmowania trafnych decyzji operacyjnych i strategicznych.
Jaki jest dobry wskaźnik FCR dla service desku?
Według Service Quality Measurement Group standard branżowy dla zdrowego wskaźnika FCR wynosi od 70% do 79%. Wartości poniżej 70% wskazują, że znaczna część zgłoszeń wymaga wielu interakcji do rozwiązania, co bezpośrednio wpływa na CSAT i zwiększa koszt jednego kontaktu. Wyniki powyżej 79% są osiągalne, ale w dużej mierze zależą od złożoności obsługiwanych zgłoszeń oraz dojrzałości infrastruktury samoobsługi i bazy wiedzy.

