





Le metriche dell'help desk offrono un modo concreto per comprendere le prestazioni quotidiane del proprio team di assistenza. Si concentrano su elementi misurabili dell'attività di assistenza IT, quali il numero di ticket ricevuti, il tempo necessario per rispondere, il grado di soddisfazione degli utenti dopo un'interazione o il costo di gestione di ciascuna richiesta.
Una buona serie di metriche ti aiuta a monitorare lo stato di salute delle tue operazioni di assistenza senza perderti nei dettagli tecnici. Puoi individuare rapidamente le tendenze nel volume dei ticket, identificare i rallentamenti nei tempi di prima risposta o vedere dove la qualità del servizio subisce un calo.
Di seguito troverai 19 metriche relative all’help desk e al service desk che dovrebbero essere misurate nel 2026, complete di formule, valori di riferimento e una guida per interpretare ciascuna di esse senza trarre conclusioni fuorvianti.
Punti chiave
Le metriche dell’help desk sono indicatori quantificabili che valutano le prestazioni e l’efficacia dei team di assistenza. Raccolgono dati operativi quali il volume dei ticket, il tempo di prima risposta, i punteggi CSAT e il costo per ticket. Queste misurazioni aiutano a comprendere i modelli di carico di lavoro, la qualità del servizio e l’efficienza dei flussi di lavoro dell’assistenza.
Forniscono inoltre una visione oggettiva di come le richieste si muovono attraverso il processo di assistenza. I modelli nella domanda in entrata, i ritardi nella risposta o nella risoluzione e le fluttuazioni nel feedback degli utenti diventano visibili quando le metriche vengono monitorate con costanza.
Sebbene presentino alcune somiglianze, le metriche dell’help desk e gli indicatori chiave di prestazione (KPI) hanno scopi e obiettivi diversi.
Una metrica riporta i dati; un KPI valuta. Tutti i KPI utilizzano le metriche, ma non tutte le metriche sono KPI.
Ad esempio, FRT e TTR sono metriche operative, ma quando si imposta un obiettivo come “rispondere in media entro 15 minuti” o “risolvere gli incidenti standard entro otto ore”, diventano parte di un KPI che monitora l’efficienza. Le stesse metriche supportano anche un KPI incentrato sulla soddisfazione quando le si collega alle tendenze del CSAT, poiché le risposte o le risoluzioni lente sono spesso correlate a valutazioni più basse da parte degli utenti.
Il monitoraggio dei KPI corretti del service desk fornisce ai team IT una base solida per prendere decisioni che altrimenti sarebbero basate solo sull’istinto. Nello specifico, essi supportano:
Monitorare le metriche senza collegarle a un obiettivo è utile per la diagnosi, ma poi arriva la fase operativa. “Migliorare la soddisfazione del cliente” come obiettivo non è sufficiente. Ciò che conta è se il CSAT cala costantemente in seguito a un tipo specifico di richiesta, o se la conformità agli SLA sta diminuendo per un determinato reparto — perché questi sono i segnali che portano a una decisione concreta: adeguare gli SLA, rivedere l’organico in quell’area o risolvere un collo di bottiglia nella coda.
L’utilizzo delle metriche dell’help desk per definire e adeguare i KPI è una best practice del service desk; è il modo per promuovere il miglioramento.
Per garantire la chiarezza del quadro di riferimento, le metriche riportate in questo articolo sono raggruppate in quattro categorie.
Non è necessario misurare tutto per tenere sotto controllo un’attività di assistenza. L’obiettivo è selezionare le metriche che riflettono il modo di lavorare del vostro team, monitorarle con costanza e adeguare l’insieme man mano che il vostro service desk si evolve.
Questo elenco vi aiuta a confrontare gli indicatori all’interno della stessa categoria — produttività, qualità, prestazioni o impatto finanziario — in modo da poter decidere quali siano in linea con i risultati che desiderate migliorare.
Gli indicatori di produttività misurano il rapporto tra il carico di lavoro e la capacità del team di elaborare i ticket a un ritmo costante. Ti aiutano a valutare la produttività, a identificare i punti di congestione nella coda e a determinare quando sono necessari adeguamenti in termini di organico, pianificazione o flusso di lavoro.
Il volume dei ticket è il numero di incidenti o richieste che il supporto IT riceve e gestisce in un determinato periodo. Misura il carico di lavoro e l’efficienza del team di assistenza clienti.
È inoltre possibile suddividere il volume dei ticket per canale (e-mail, portale, telefono, chat), categoria, priorità, servizio, gruppo di clienti e periodo di tempo (ora/giorno/settimana). In questo modo, è possibile utilizzare questa metrica per correlare i picchi con i rilasci, apportare modifiche alla configurazione, stabilire soglie di allerta per aumenti anomali e altro ancora.
L’arretrato dei ticket misura il numero totale di ticket che gli agenti non hanno risolto in un determinato periodo. Fornisce informazioni sul carico di lavoro del personale di supporto IT, sull’efficienza del sistema di assistenza e sulla soddisfazione dei clienti. L’analisi delle tendenze, affiancata da un modello di sondaggio sulla soddisfazione dei clienti, aiuta i team a stabilire le priorità dei problemi, ridurre i ritardi, migliorare la qualità delle risoluzioni, allocare le risorse in modo più intelligente e allineare le prestazioni dell’assistenza alle aspettative e ai risultati in continua evoluzione degli utenti.
Un arretrato elevato può indicare che il team di assistenza IT è sovraccarico di lavoro, con conseguenti ritardi nei tempi di risoluzione e scarsa soddisfazione dei clienti.
L’utilizzo degli agenti misura il tempo che un agente dell’assistenza IT dedica alle attività relative all’assistenza rispetto al proprio tempo di lavoro totale disponibile.
Sebbene si tratti per lo più di un semplice rapporto, il dato può essere fuorviante se non si definisce cosa si intende per “tempo dedicato all’assistenza”. Due service desk che utilizzano la stessa formula possono ottenere tassi di utilizzo molto diversi a seconda del modo in cui monitorano il lavoro. Ecco perché questa metrica richiede un contesto più ampio rispetto al semplice calcolo.
Non tutto il lavoro relativo alla gestione degli incidenti risulta come tempo diretto dedicato ai ticket. Indagini, follow-up, discussioni interne, escalation e attività amministrative possono occupare una parte significativa della giornata. Se si tiene traccia solo del tempo registrato direttamente sui ticket, l’utilizzo potrebbe apparire inferiore al carico effettivo. Se invece si includono tutte le attività senza distinzioni, potrebbe risultare artificialmente elevato.
Tra i possibili approcci di misurazione figurano:
Le metriche di qualità valutano i risultati del service desk dal punto di vista dell’utente. Si concentrano sulla coerenza, sull’affidabilità e sul valore percepito dell’esperienza di assistenza. Questi indicatori aiutano a comprendere l’efficacia con cui il team risolve i problemi, se i livelli di servizio soddisfano le aspettative e come gli utenti valutano lo sforzo necessario per ottenere assistenza. Nel loro insieme, offrono una visione concreta della qualità del servizio che va oltre la semplice produttività o velocità.
Il punteggio di soddisfazione del cliente misura il grado di soddisfazione dei clienti riguardo all’assistenza IT ricevuta. La metrica CSAT viene solitamente misurata chiedendo ai clienti di valutare il proprio livello di soddisfazione rispetto all’assistenza IT ricevuta, di solito su una scala da 1 a 5 o da 1 a 10.
Il CSAT è un indicatore anticipatore della qualità dell’esperienza e aiuta a identificare le aree di miglioramento. È consigliabile monitorare il CSAT regolarmente, idealmente dopo ogni interazione con i clienti.
Il CSAT riflette anche il sentiment relativo all’intera esperienza, non solo alle prestazioni del reparto IT: ritardi causati da team esterni, processi poco chiari o decisioni politiche possono abbassare la valutazione anche quando l’operatore ha agito correttamente.
Il Net Promoter Score indica la probabilità che i clienti raccomandino un’azienda o i suoi prodotti/servizi ad altri. Si tratta di un indicatore ampiamente utilizzato che aiuta le organizzazioni a comprendere la fedeltà e la soddisfazione dei clienti. Inoltre, le organizzazioni lo utilizzano per confrontare le prestazioni di diversi prodotti o servizi e per valutare l’efficacia delle modifiche apportate alle iniziative relative all’esperienza del cliente.
L’NPS viene solitamente calcolato ponendo ai clienti un’unica domanda: "Su una scala da 0 a 10, quanto è probabile che consigli la nostra azienda/i nostri prodotti/servizi a un amico o a un collega?" In base alla risposta fornita, i clienti vengono poi classificati in tre categorie: Promotori (9-10), Passivi (7-8) e Detrattori (0-6).
A differenza del CSAT, l’NPS viene solitamente inviato con minore frequenza e riflette l’esperienza accumulata. Gli utenti interpretano inoltre la domanda in modo diverso a seconda della cultura organizzativa, delle aspettative di servizio o del grado di visibilità dell’IT. Un NPS basso non riflette sempre le prestazioni recenti; potrebbe essere legato a problemi pregressi o a un’insoddisfazione più ampia nei confronti della tecnologia all’interno dell’azienda.
La conformità all’Accordo sul livello di servizio misura il grado in cui un team di supporto IT soddisfa gli obiettivi e gli standard definiti nel proprio SLA. Uno SLA è un accordo formale tra il team di supporto IT e i propri clienti, che delinea i servizi dell’organizzazione, il livello di supporto previsto e i tempi di risoluzione dei problemi.
Non tutti gli SLA riflettono le reali aspettative degli utenti. Obiettivi fissati a un livello troppo basso gonfiano il tasso di conformità, mentre quelli eccessivamente rigidi generano continui mancati raggiungimento che non rispecchiano le prestazioni effettive. Un approccio pratico consiste nell’analizzare le tendenze relative ai tipi di ticket, all’instradamento e alla gestione delle code, per poi adeguare le soglie con piccoli incrementi anziché passare direttamente a nuovi valori. È inoltre utile confrontare gli SLA con gli OLA interni, in modo che i team di assistenza non siano vincolati a promesse che i gruppi a monte non sono in grado di mantenere.
Anche la classificazione necessita di una rapida verifica, poiché categorie incoerenti distorcono i dati relativi alle risposte e alle risoluzioni. Un breve ciclo di calibrazione ogni pochi mesi di solito mantiene gli SLA realistici senza renderli troppo permissivi.
Il Customer Effort Score misura la facilità con cui un utente è riuscito a risolvere il proprio problema o a completare una richiesta. Si concentra sulle difficoltà incontrate nel processo piuttosto che sul risultato finale.
Il Customer Effort Score viene solitamente misurato ponendo ai clienti una singola domanda dopo l’interazione con il team di assistenza: «Quanto impegno hai dovuto profondere per gestire la tua richiesta?». Ai clienti viene quindi chiesto di valutare la propria esperienza su una scala che va da «molto facile» a «molto difficile».
Il CES è fortemente influenzato dalla progettazione dei processi. Anche una prestazione eccellente da parte degli agenti non può compensare flussi di lavoro che richiedono approvazioni multiple, ripetizione delle informazioni, moduli lunghi o passaggi di consegne. Ciò rende il CES un indicatore sensibile degli attriti strutturali piuttosto che delle prestazioni individuali.
Le metriche di prestazione valutano la rapidità e l’efficacia con cui il team di assistenza gestisce il lavoro. Aiutano a comprendere la velocità di risposta, i modelli di risoluzione e l’andamento del carico di lavoro.
Tempo di prima risposta è il tempo impiegato da un team di assistenza IT per rispondere alla richiesta iniziale di assistenza da parte di un cliente. Non tiene conto del tempo necessario per risolvere il problema. Si tratta di un indicatore chiave di prestazione utilizzato per valutare la reattività dei team di assistenza IT.
Gli intervalli di FRT dipendono dal canale (e-mail, chat, portale). È opportuno esaminare i modelli di risposta naturali e adeguare l’obiettivo in modo che rifletta le aspettative reali senza essere gonfiato. Se il team modifica le regole di instradamento o passa a nuovi canali, è necessario rivedere l’obiettivo poiché il valore di riferimento potrebbe cambiare.
La risoluzione al primo contatto è la capacità di un team di assistenza IT di risolvere i problemi o le richieste dei clienti durante il primo contatto del cliente con il team di assistenza, senza necessità di ulteriori interventi.
Quando si definiscono gli obiettivi di FCR, è opportuno verificare quali categorie possano effettivamente essere risolte al primo contatto e stabilire aspettative specifiche per ciascuna categoria, anziché fissare un unico obiettivo globale. È inoltre utile monitorare se la qualità dell’assistenza diminuisce quando si punta a un FCR più elevato; se le risoluzioni rapide comportano un aumento dei tassi di riapertura, l’obiettivo deve essere adeguato.
Il tempo di risoluzione misura iltempo necessario per risolvere completamente un ticket dal momento in cui viene aperto.
Per calcolare il TTR, sottrai l'ora in cui il cliente ha effettuato la richiesta dall'ora in cui il problema è stato risolto.
Il TTR misura il tempo complessivo necessario per risolvere il problema, compresi eventuali contatti di follow-up o escalation.
Il TTR varia notevolmente a seconda del tipo di incidente, quindi un unico parametro di riferimento spesso non rappresenta correttamente le prestazioni. Fissare un obiettivo globale troppo rigido costringe a costanti eccezioni, mentre uno troppo ampio nasconde i ritardi nelle categorie che contano davvero. L’approccio più affidabile consiste nell’analizzare i tempi di risoluzione storici per categoria o gravità e definire fasce che riflettano la variazione reale.
Il tempo medio di gestione (AHT) misura il tempo medio impiegato da un addetto all’assistenza IT per gestire una richiesta, compreso il tempo dedicato alla conversazione con il cliente e a qualsiasi attività correlata, come la ricerca o la documentazione.
È importante bilanciare l’AHT con altre metriche, in particolare con gli indicatori di qualità dell’assistenza come la soddisfazione del cliente, e utilizzarlo come parametro di tendenza piuttosto che come obiettivo rigido, per evitare di distorcere il comportamento.
Ad esempio, un addetto all’assistenza IT potrebbe essere in grado di gestire rapidamente le richieste; tuttavia, se non fornisce soluzioni efficaci o se i clienti non sono soddisfatti delle interazioni, l’AHT da solo potrebbe non fornire un quadro completo della qualità dei servizi di assistenza IT.
Il tasso di escalation è la percentuale di richieste inoltrate a livelli superiori di assistenza o gestione. Misura la frequenza con cui i problemi non possono essere risolti dal team di assistenza iniziale e richiedono un ulteriore intervento.
Il tasso di escalation fornisce un quadro attendibile solo quando la logica di instradamento è stabile. Qualsiasi modifica alle regole di triage, alla struttura delle code o alle responsabilità dei team può alterare il tasso da un giorno all’altro, facendo apparire la metrica peggiore o migliore senza alcun reale cambiamento nelle prestazioni. Quando si regolano le soglie, verificare se le escalation derivano da carenze di competenze, disallineamenti nelle categorie o limiti di autorizzazione troppo rigidi. Imposta intervalli accettabili per categoria o gravità, anziché applicare un valore unico. Se il tasso scende troppo, verifica che i casi non vengano mantenuti al livello 1 solo per proteggere la metrica.
La gravità dell’incidente misura l’impatto di un incidente IT sulle operazioni, sui servizi o sui clienti dell’organizzazione. Classifica gli incidenti in base al livello di interruzione o all’impatto che hanno sull’attività aziendale.
Esistono generalmente quattro livelli di gravità degli incidenti:
Per assegnare un livello di gravità a un incidente, è necessario basarsi sul suo impatto e sulla sua urgenza. È possibile prendere in considerazione fattori quali il numero di utenti coinvolti, la criticità del sistema o del servizio e il potenziale impatto sui ricavi.
I dati relativi alla gravità sono utili solo se le categorie vengono applicate in modo coerente. Se le soglie sono vaghe, si verifica un’inflazione della gravità o una sottoclassificazione che si diffonde lungo la coda e distorce il TTR, le prestazioni degli SLA e l’allocazione delle risorse. Una revisione periodica degli esempi per ciascuna categoria aiuta a mantenere stabile il modello.
Le metriche finanziarie mostrano l’impatto economico della gestione del service desk. Aiutano a quantificare il costo della gestione della domanda, a confrontare le prestazioni interne con i benchmark e a supportare le decisioni di bilancio relative al personale, agli strumenti e al miglioramento dei processi.
Il costo per ticket è il costo medio necessario per risolvere un ticket di assistenza IT. Aiuta le organizzazioni a comprendere l’impatto finanziario dei propri processi di assistenza IT e può orientare le decisioni relative all’allocazione delle risorse e all’efficienza.
I team decidono se includere i costi indiretti (formazione, abbonamenti software, addebiti interni). L’importante è mantenere il modello coerente affinché le tendenze rimangano affidabili.
Se monitorato nel tempo, questo dato può fornire informazioni sull’efficacia delle modifiche ai processi o degli investimenti tecnologici. Ad esempio, se viene implementato un nuovo strumento o processo di help desk e il costo per ticket diminuisce nel tempo, ciò può essere interpretato come un segno che l’investimento ha avuto successo.
ROI è l’acronimo di Return on Investment(ritorno sull’investimento), che misura l’efficienza di un investimento. Le organizzazioni lo utilizzano per valutare i rendimenti finanziari degli investimenti in infrastrutture IT, software o altri progetti legati alla tecnologia.
I benefici possono essere diretti (riduzione delle ore di lavoro) o indiretti (maggiore FCR che riduce i tempi di inattività dell’azienda). L’aspetto fondamentale è definire i benefici in anticipo, in modo che i calcoli del ROI non si basino su ipotesi a posteriori.
Monitorare il ROI nel tempo consente alle aziende di determinare se l’investimento ha avuto successo e se sono giustificati ulteriori investimenti in tecnologie simili.
Le metriche relative all’IA e alla deviazione monitorano la percentuale di richieste di assistenza risolte senza il coinvolgimento degli operatori, tramite self-service, basi di conoscenza e agenti virtuali. Mostrano in quali punti l’automazione assorbe la domanda, con quale efficacia gli utenti risolvono i problemi autonomamente e quali parti della coda non raggiungono mai un operatore umano. Man mano che il self-service e la risoluzione assistita dall’IA assumono una quota sempre maggiore delle attività di assistenza, questi indicatori rivelano se tale cambiamento riduce il carico di lavoro degli agenti o lo sposta a valle.
Il tassodi deviazione dei ticket misura la percentuale di potenziali ticket risolti tramite il self-service prima che raggiungano un operatore. Riflette l’efficacia con cui le basi di conoscenza, i portali e gli agenti virtuali assorbono la domanda che altrimenti finirebbe in coda.
La deviazione ha senso solo quando l’interazione deviata risolve effettivamente il problema dell’utente. La consultazione di una base di conoscenza o una sessione con un chatbot che termina senza una risposta può essere registrata come deviazione, mentre il problema di fondo rimane irrisolto, gonfiando così il tasso. Abbina la deviazione a un segnale di follow-up — un contatto ripetuto entro un breve lasso di tempo, una risposta alla domanda “È stato utile?” o un ticket successivo sullo stesso argomento — per confermare che i ticket evitati riflettano problemi risolti.
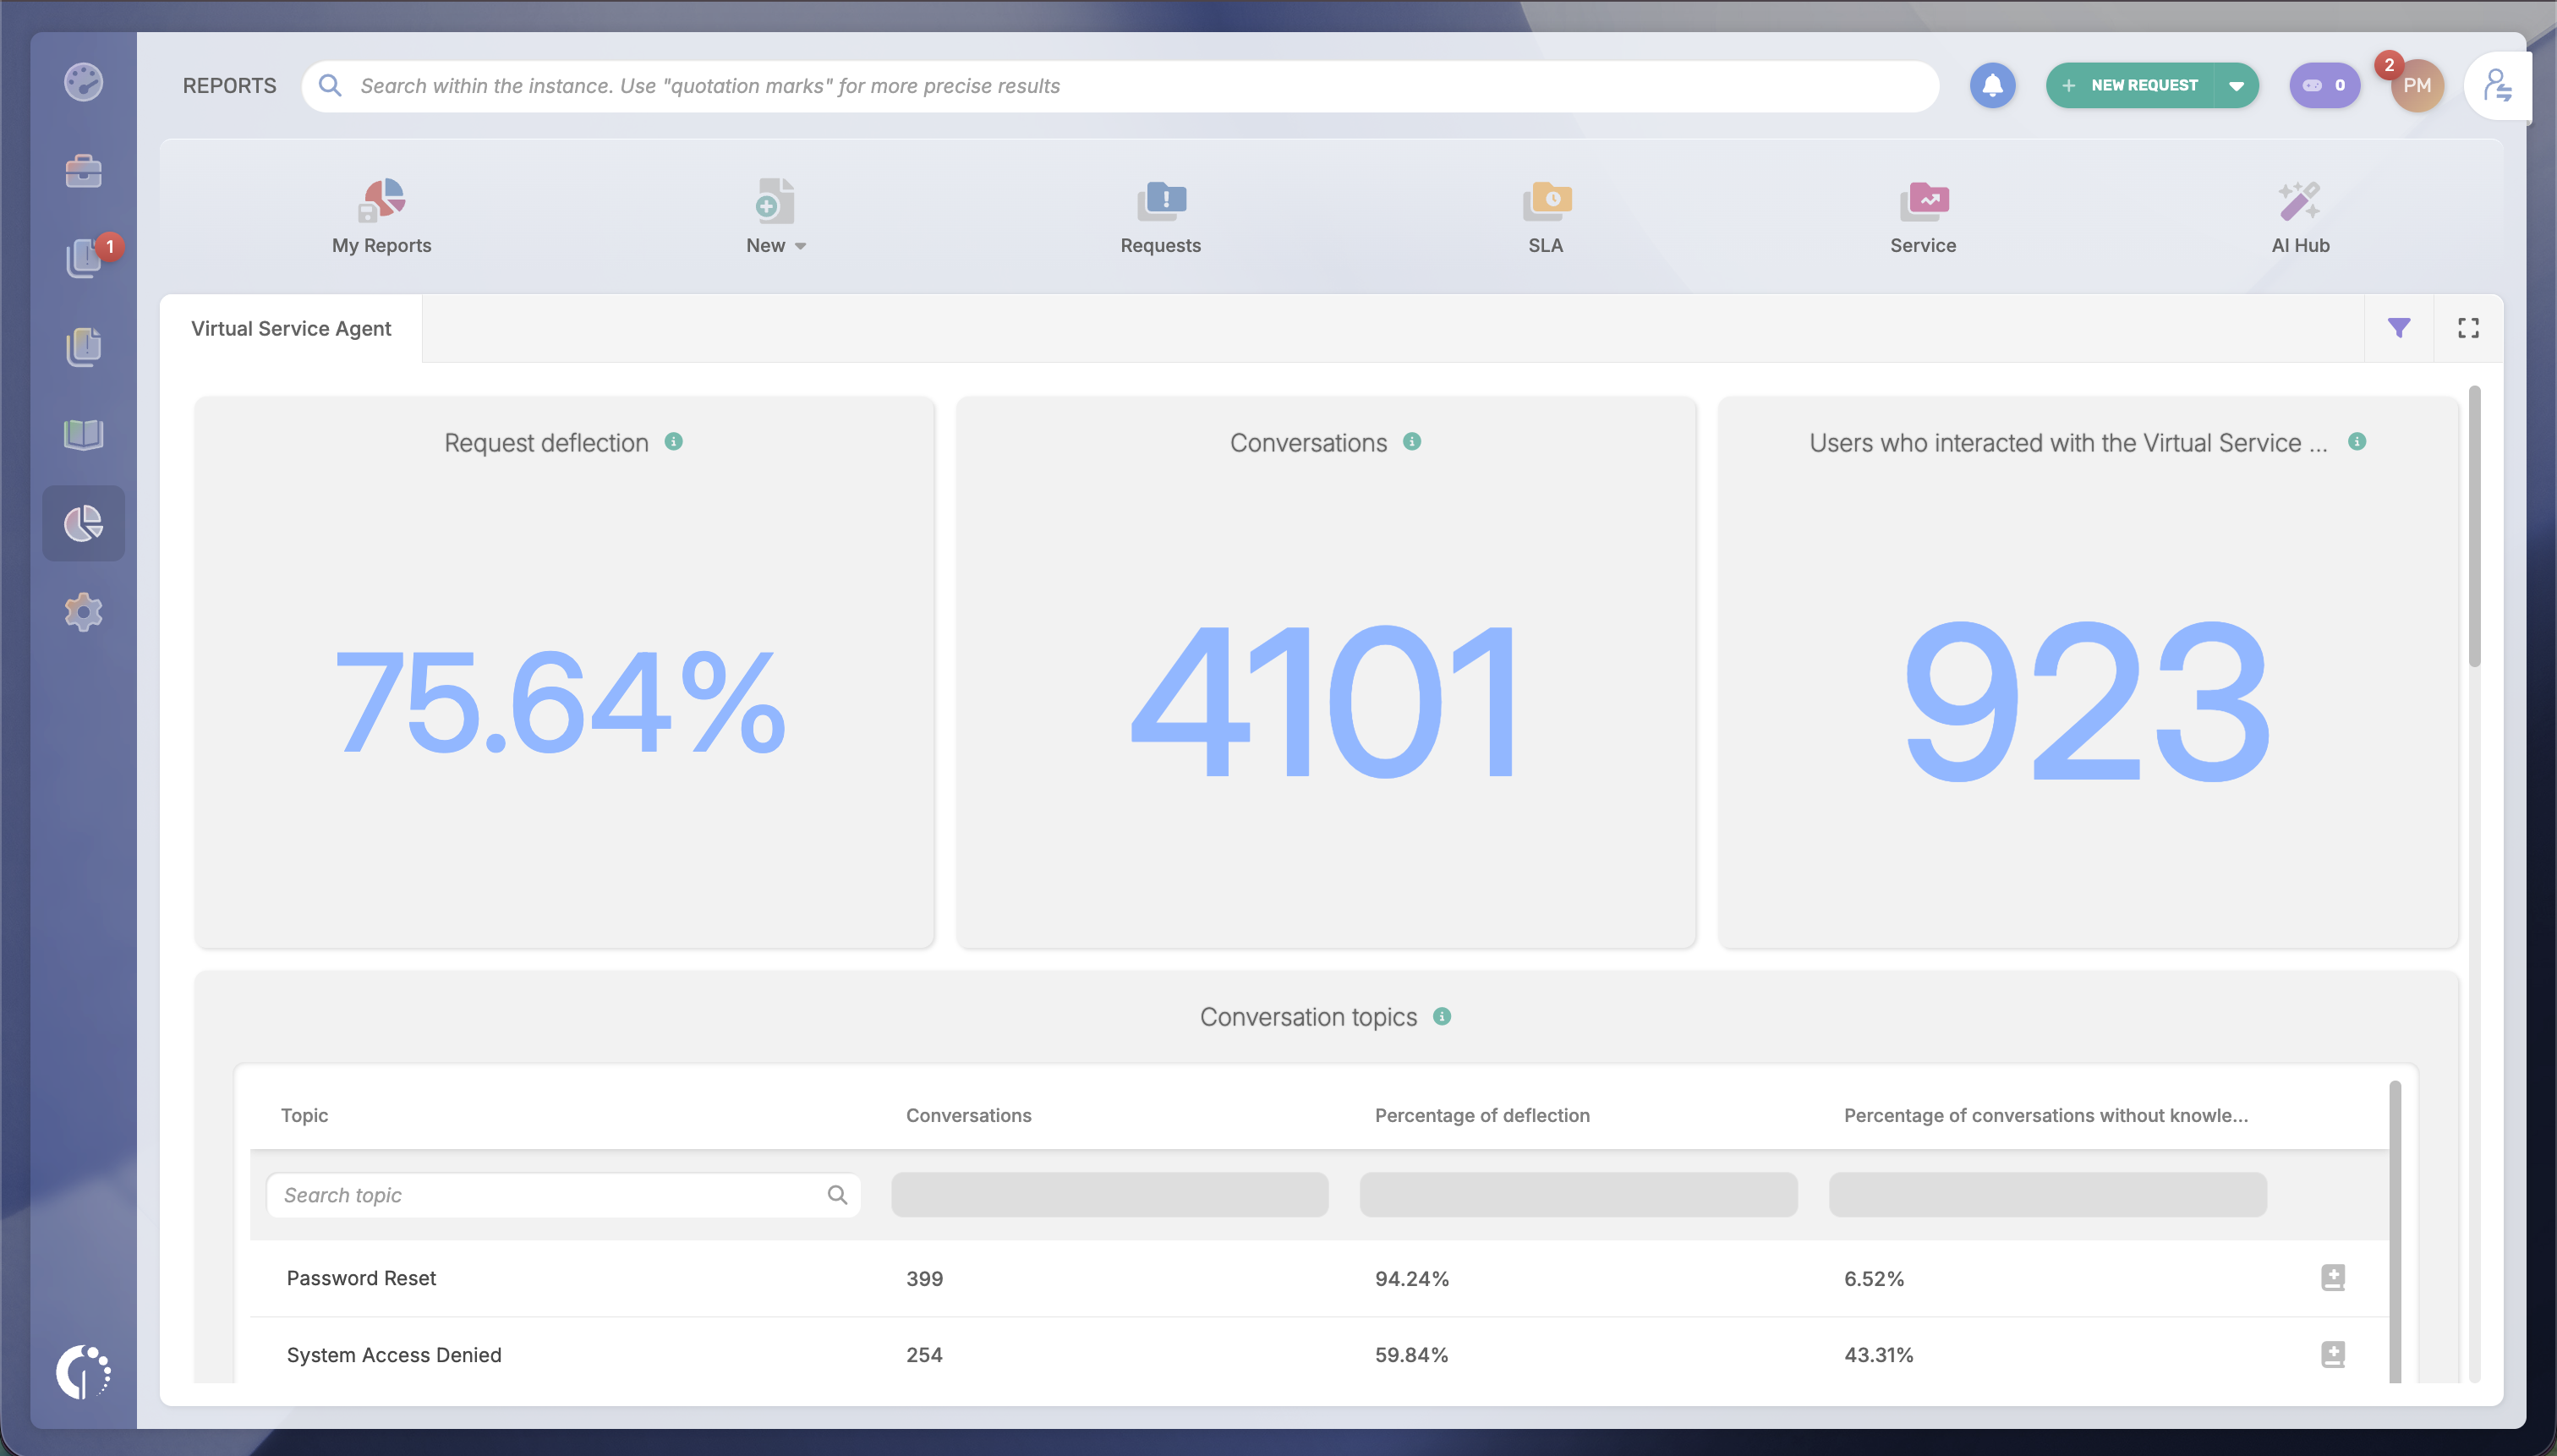
Il tasso di successo del self-service misura la percentuale di utenti che risolvono il proprio problema tramite i canali di self-service dopo aver iniziato la ricerca da lì. Esso isola l’efficacia della knowledge base e del portale dal traffico complessivo, mostrando se i contenuti che gli utenti trovano risolvono effettivamente la loro richiesta.
L’attribuzione rappresenta la sfida principale. Un utente potrebbe leggere un articolo, uscire dal sito e risolvere il problema altrove, oppure abbandonare la sessione e aprire un ticket ore dopo. Definire una finestra di risoluzione e collegare le sessioni ai contatti successivi garantisce l’affidabilità della metrica. Tassi di successo bassi di solito indicano lacune nei contenuti o problemi di ricerca, quindi segmenta la metrica per argomento per individuare dove la knowledge base è carente e dove nuovi articoli potrebbero risolvere il maggior numero di richieste.
Il tasso di contenimento degli agenti virtuali misura la percentuale di conversazioni che un agente virtuale gestisce dall’inizio alla risoluzione senza passare il testimone a un operatore umano. Mostra quanta domanda conversazionale viene assorbita dall’automazione e dove si concentrano i modelli di escalation.
Un tasso di contenimento elevato ha significato solo quando le conversazioni contenute si concludono con un utente soddisfatto. Le sessioni che si bloccano, entrano in loop o vengono abbandonate possono essere conteggiate come contenute pur spingendo gli utenti verso un altro canale, il che nasconde il reale carico di escalation. Monitorate il contenimento insieme alla soddisfazione post-conversazione e ai tassi di contatto ripetuto per confermare che un numero in aumento rifletta un intento risolto.
Il tasso di risoluzione automatizzata misura la percentuale di ticket risolti tramite flussi di lavoro automatizzati senza l’intervento di un operatore una volta che il ticket è stato creato. Esso rileva il valore dell’automazione applicata dopo l’accettazione — instradamento, categorizzazione e chiusura gestiti da regole o dall’intelligenza artificiale — distinguendolo dalla deviazione che avviene prima della creazione del ticket.
Il confine tra risoluzione assistita dall’automazione e risoluzione completamente automatizzata determina questo dato. Un ticket che viene instradato e arricchito dall’automazione prima che un operatore lo chiuda è diverso da uno che viene chiuso dall’inizio alla fine senza l’intervento umano. Decidete quali casi considerare automatizzati prima di riportare il tasso e mantenete la definizione costante nel tempo, in modo che le tendenze rimangano comparabili. La segmentazione per tipo di richiesta mostra quali categorie sono ottime candidate all’automazione e quali dipendono ancora dal giudizio umano
Un solido modello di misurazione aiuta i team di supporto IT a comprendere la domanda, la qualità del servizio e i costi operativi. Le metriche sulle prestazioni dell’help desk offrono inoltre ai manager un modo chiaro per collegare il lavoro quotidiano agli obiettivi aziendali più ampi. Se monitorate con costanza, guidano gli adeguamenti dei processi, le decisioni relative al personale e i miglioramenti del servizio.
Un approccio strutturato garantisce che le metriche mantengano il loro significato ed evita che i dati diventino solo rumore di fondo. Quattro passaggi pratici possono aiutarti a stabilire un processo solido:
InvGate Service Management semplifica l’automazione del monitoraggio delle metriche ed elimina la necessità di report manuali.
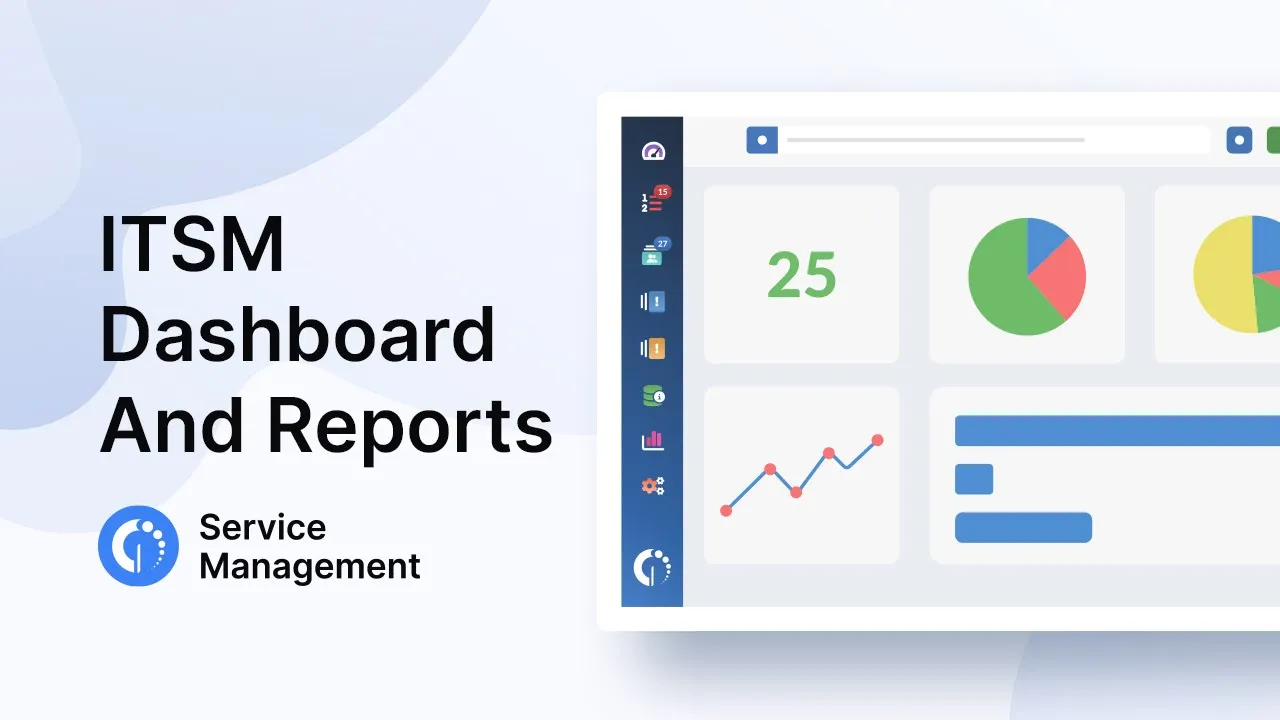
I dashboard in InvGate Service Management si configurano tramite comandi "punta e clicca" e "trascina e rilascia".
Poiché InvGate Service Management supporta più help desk e diversi livelli di accesso, lo stesso vale per il livello di analisi, che fornisce strumenti di reportistica per coordinatori e amministratori in ciascuna area di responsabilità. Ciò elimina il problema dei dashboard “universali” che mostrano tutto a tutti e non sono utili a nessuno.
I dashboard possono inoltre essere condivisi con le parti interessate al di fuori del team del service desk, offrendo ai dirigenti aziendali una visibilità in tempo reale sulle prestazioni del servizio senza richiedere l’accesso alla piattaforma completa.
È qui che avviene, a livello operativo, la conversione delle metriche in KPI.
In InvGate Service Management, le politiche SLA convertono metriche come FRT e TTR in obiettivi con logica di allerta. È sufficiente configurare la soglia — ad esempio, «Gli incidenti di livello P2 devono essere risolti entro 8 ore» — e il sistema monitora la conformità in tempo reale. Quando un ticket si avvicina al limite SLA, la piattaforma può attivare automaticamente una notifica, riassegnare il ticket, inoltrarlo al livello successivo o modificarne la priorità.
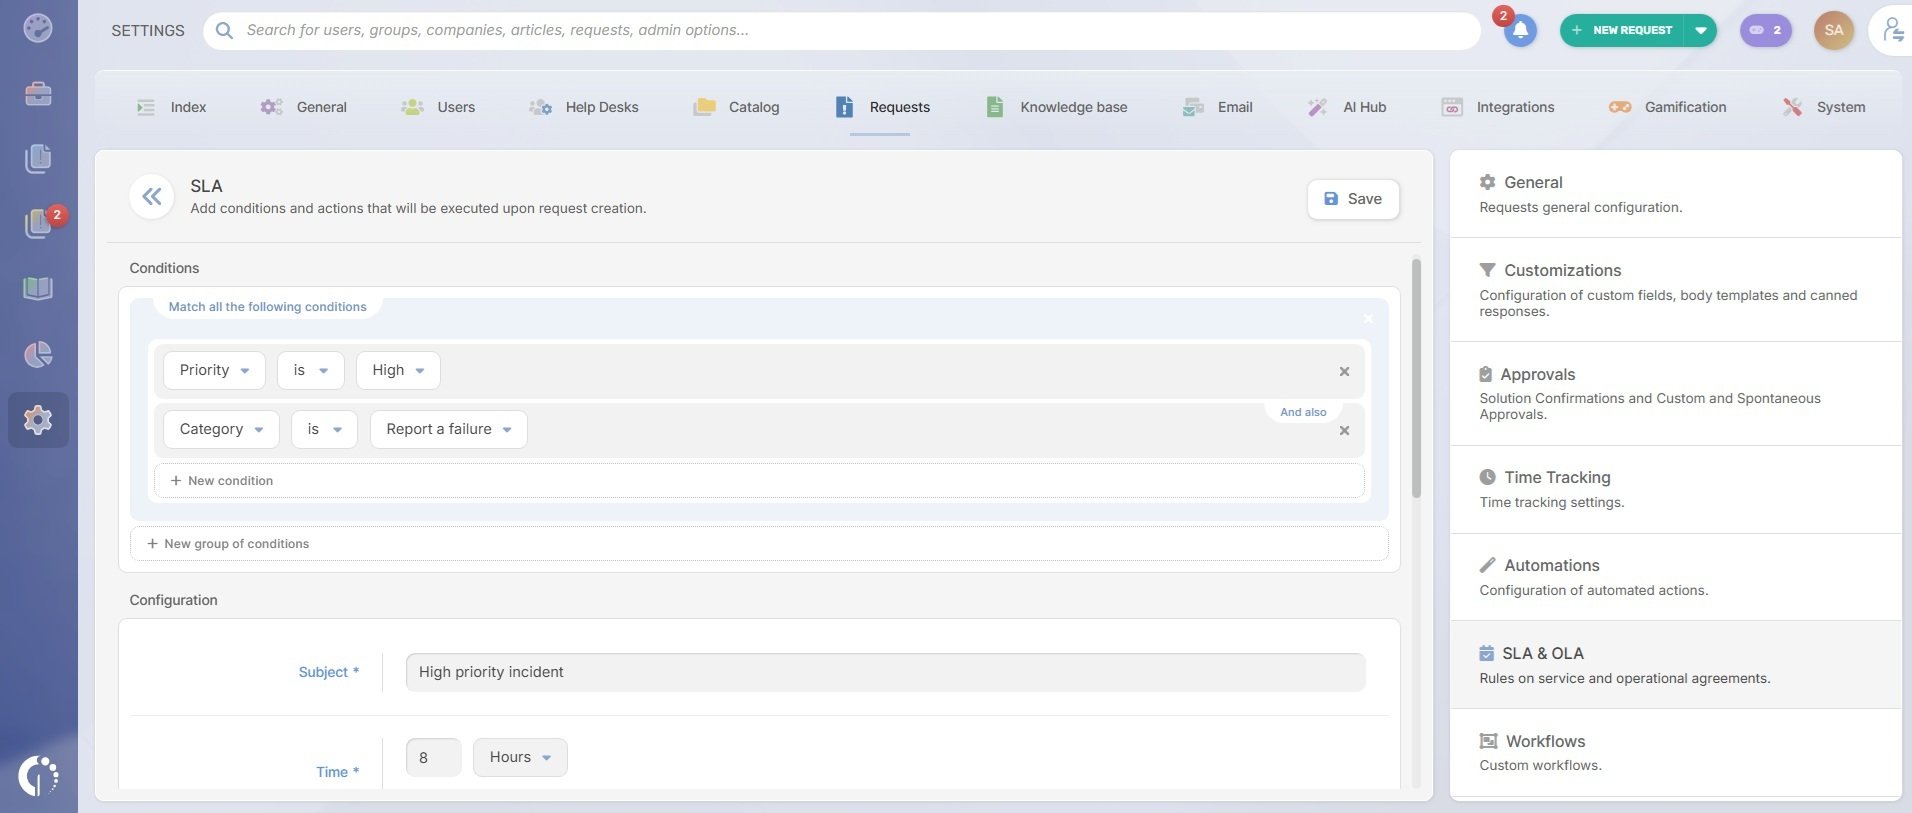
I report possono essere configurati per includere gli indicatori specifici che contano per il vostro service desk — come il FRT, la conformità allo SLA o il costo per ticket.
Per crearne uno, apri Report → Richieste → Nuovo report, scegli le metriche, specifica un intervallo di date e applica i filtri necessari. Una volta salvato, puoi pianificarne l’invio automatico utilizzando l’icona dell’orologio e selezionare la frequenza e i destinatari. I report possono essere inviati sia agli utenti con licenza che a quelli senza licenza, il che è utile quando si condividono aggiornamenti con altri team o manager.
I dashboard offrono una visione in tempo reale delle prestazioni. Possono essere personalizzati con widget relativi a backlog, escalation, tempi di risposta o metriche finanziarie per monitorare le operazioni quotidiane. Queste visualizzazioni aiutano a individuare tempestivamente eventuali scostamenti e favoriscono un processo decisionale più rapido.
Vuoi vedere come funziona nella pratica? Richiedi una prova gratuita di 30 giorni ed esplora InvGate Service Management e tutte le sue funzionalità.
Monitorare 15 metriche non significa gestire 15 KPI. La distinzione è importante: le metriche forniscono una copertura diagnostica; i KPI promuovono la responsabilità e il miglioramento.
L’intervallo consigliato per la maggior parte dei team è di 5–7 KPI. Se sono meno di 5, si perde la copertura delle quattro famiglie. Se sono più di 7, diventa difficile identificare quali leve azionare quando le prestazioni calano.
Ecco un modello in tre fasi per convertire le metriche sopra indicate in KPI su cui il vostro team possa agire.
Iniziate dal risultato su cui l’azienda deve incidere nel ciclo attuale, non dalle metriche. Esempi:
Ogni obiettivo corrisponde a un insieme di metriche. I KPI sono quelle metriche a cui è associato un obiettivo.
Un KPI senza un obiettivo rimane comunque una metrica. Per ciascun indicatore selezionato, stabilire a che livello si trova attualmente la prestazione (la linea di base) e a quale livello deve arrivare entro il ciclo di revisione (l’obiettivo). Il divario tra i due definisce l’obiettivo di miglioramento. Per indicazioni su come impostare obiettivi basati sugli SLA che siano realistici e allineati alle aspettative aziendali, consultare la guida alla creazione di SLA ITSM efficaci.
I diversi KPI seguono ritmi di revisione diversi:
Questa cadenza evita la trappola comune di esaminare tutto con la stessa frequenza: si rischia infatti di trascurare i segnali in rapida evoluzione (metriche operative) o di reagire in modo eccessivo alle fluttuazioni a breve termine (metriche strategiche).
Quali sono le metriche più importanti per l'help desk?
Le metriche più critiche per la maggior parte dei team sono FCR (First Contact Resolution, risoluzione al primo contatto), FRT (First Response Time, tempo di prima risposta), tasso di conformità agli SLA e CSAT. Insieme, questi indicatori coprono la velocità, la qualità della risoluzione, il rispetto degli impegni di servizio e la soddisfazione percepita dagli utenti. La scelta di quali di questi indicatori privilegiare come KPI dipende dall’obiettivo aziendale specifico su cui il team deve incidere nell’attuale ciclo di valutazione: un team che lavora alla riduzione dei costi darà un peso diverso all’utilizzo degli agenti e al costo per ticket rispetto a uno che si concentra sul miglioramento dell’esperienza utente.
Qual è la differenza tra metriche dell’help desk e KPI?
Una metrica è un dato operativo: misura ciò che è avvenuto nel processo di assistenza — ad esempio, il tempo medio di risoluzione. Un KPI è una metrica legata a un obiettivo specifico con un traguardo definito — ad esempio, risolvere il 90% degli incidenti di livello P2 entro 8 ore. Tutti i KPI utilizzano metriche, ma non tutte le metriche sono KPI. La distinzione è importante dal punto di vista operativo: le metriche forniscono una copertura diagnostica in tutto il service desk; i KPI guidano la responsabilità, gli avvisi e i cicli di miglioramento.
Come si misurano le prestazioni dell’help desk?
Combinando le metriche delle quattro famiglie: produttività (volume dei ticket, arretrati, utilizzo degli agenti), qualità (CSAT, NPS, conformità agli SLA, CES), prestazioni (FRT, TTR, FCR, tasso di riapertura dei ticket) e costo (costo per ticket, tasso di risoluzione tramite self-service). Misurare solo una di queste famiglie offre un quadro incompleto: un team con un TTR basso ma un costo per ticket elevato e un CSAT basso non sta ottenendo buoni risultati nel complesso. Le quattro famiglie insieme forniscono l’equilibrio necessario per prendere decisioni operative e strategiche oculate.
Qual è un buon tasso di FCR per un service desk?
Secondo il Service Quality Measurement Group, lo standard di settore per un tasso di FCR soddisfacente è compreso tra il 70% e il 79%. Tassi inferiori al 70% indicano che una percentuale significativa di ticket richiede più interazioni per essere risolta, il che influisce direttamente sul CSAT e fa aumentare il costo per contatto. Tassi superiori al 79% sono raggiungibili, ma dipendono fortemente dalla complessità del mix di richieste e dalla maturità dell’infrastruttura di self-service e della knowledge base.

