





Helpdesk-Kennzahlen bieten Ihnen eine konkrete Möglichkeit, die tägliche Leistung Ihres Support-Teams zu beurteilen. Sie konzentrieren sich auf messbare Aspekte der IT-Supportarbeit, beispielsweise darauf, wie viele Tickets eingehen, wie lange die Beantwortung dauert, wie zufrieden die Nutzer nach einer Interaktion sind oder wie viel die Bearbeitung jeder Anfrage kostet.
Ein gutes Kennzahlenset hilft Ihnen dabei, den Zustand Ihres Supportbetriebs im Blick zu behalten, ohne sich in technischen Details zu verlieren. Sie können schnell Trends beim Ticketvolumen erkennen, Verzögerungen bei der ersten Antwortzeit feststellen oder sehen, wo die Servicequalität nachlässt.
Im Folgenden finden Sie 19 Helpdesk- und Service-Desk-Kennzahlen, die im Jahr 2026 gemessen werden sollten , einschließlich Formeln, Referenzwerten und einer Anleitung zur Interpretation der einzelnen Kennzahlen, ohne dabei zu irreführenden Schlussfolgerungen zu gelangen.
Wichtige Erkenntnisse
Helpdesk-Kennzahlen sind quantifizierbare Indikatoren, mit denen die Leistung und Effektivität von Support-Teams bewertet werden. Sie erfassen Betriebsdaten wie das Ticketvolumen, die Zeit bis zur ersten Antwort, CSAT-Werte und die Kosten pro Ticket. Diese Kennzahlen helfen Ihnen dabei, Arbeitsauslastungsmuster, Servicequalität und die Effizienz Ihrer Support-Workflows zu verstehen.
Außerdem liefern sie einen sachlichen Überblick darüber, wie Anfragen den Supportprozess durchlaufen. Muster bei eingehenden Anfragen, Verzögerungen bei der Beantwortung oder Lösung sowie Schwankungen im Nutzer-Feedback werden sichtbar, wenn die Kennzahlen konsequent überwacht werden.
Obwohl sie Gemeinsamkeiten aufweisen, verfolgen Helpdesk-Kennzahlen und Key Performance Indicators (KPIs) unterschiedliche Zwecke und Ziele.
Eine Metrik berichtet; ein KPI bewertet. Alle KPIs nutzen Metriken, aber nicht alle Metriken sind KPIs.
Beispielsweise sind FRT und TTR operative Metriken, doch wenn Sie ein Ziel wie „im Durchschnitt innerhalb von 15 Minuten antworten“ oder „Standardvorfälle innerhalb von acht Stunden lösen“ festlegen, werden sie Teil eines KPIs, der die Effizienz misst. Dieselben Metriken unterstützen auch einen auf Zufriedenheit ausgerichteten KPI, wenn man sie mit CSAT-Trends verknüpft, da langsame Antworten oder Lösungen oft mit niedrigeren Nutzerbewertungen korrelieren.
Die Erfassung der richtigen Service-Desk-KPIs bietet IT-Teams eine Entscheidungsgrundlage, die andernfalls auf Bauchgefühl beruhen würde. Konkret unterstützen sie:
Das Verfolgen von Kennzahlen ohne Verknüpfung mit einem Ziel ist für die Diagnose nützlich, doch dann folgt die operative Umsetzung. „Die Kundenzufriedenheit verbessern“ als Ziel reicht nicht aus. Entscheidend ist, ob die Kundenzufriedenheit (CSAT) bei einer bestimmten Art von Anfragen kontinuierlich sinkt oder ob die SLA-Einhaltung in einer bestimmten Abteilung nachlässt – denn das sind die Signale, die zu einer konkreten Entscheidung führen: Anpassung der SLA, Überprüfung der Personalausstattung in diesem Bereich oder Beseitigung eines Engpasses in der Warteschlange.
Die Nutzung von Helpdesk-Kennzahlen zur Definition und Anpassung von KPIs ist eine bewährte Vorgehensweise im Service Desk; auf diese Weise lassen sich Verbesserungen vorantreiben.
Um den Überblick zu bewahren, sind die Kennzahlen in diesem Artikel in vier Gruppen unterteilt.
Sie müssen nicht alles messen, um den Supportbetrieb unter Kontrolle zu halten. Das Ziel ist es, die Kennzahlen auszuwählen, die die Arbeitsweise Ihres Teams widerspiegeln, diese konsequent zu überwachen und die Auswahl anzupassen, während sich Ihr Service Desk weiterentwickelt.
Diese Liste hilft Ihnen dabei, Kennzahlen innerhalb derselben Kategorie – Produktivität, Qualität, Leistung oder finanzielle Auswirkungen – zu vergleichen, damit Sie entscheiden können, welche davon mit den Ergebnissen übereinstimmen, die Sie verbessern möchten.
Produktivitätskennzahlen messen das Verhältnis zwischen der Arbeitslast und der Fähigkeit des Teams, Tickets in einem gleichbleibenden Tempo zu bearbeiten. Sie helfen Ihnen dabei, den Durchsatz zu bewerten, Engpässe in der Warteschlange zu identifizieren und festzustellen, wann Anpassungen bei der Personalbesetzung, der Zeitplanung oder den Arbeitsabläufen erforderlich sind.
Das Ticketvolumen ist die Anzahl der Vorfälle oder Anfragen, die der IT-Support innerhalb eines bestimmten Zeitraums erhält und bearbeitet. Es misst die Arbeitslast und die Effizienz des Kundensupport-Teams.
Sie können das Ticketvolumen auch nach Kanal (E-Mail, Portal, Telefon, Chat), Kategorie, Priorität, Service, Kundengruppe und Zeit (Stunde/Tag/Woche) aufschlüsseln. Auf diese Weise können Sie die Kennzahl nutzen, um Spitzen mit Releases in Zusammenhang zu bringen, Konfigurationsänderungen vorzunehmen, Alarmschwellen für ungewöhnliche Anstiege festzulegen und vieles mehr.
Der Ticket-Rückstand misst die Gesamtzahl der Tickets, die von den Mitarbeitern in einem bestimmten Zeitraum nicht bearbeitet wurden. Er liefert Einblicke in die Arbeitsbelastung des IT-Support-Teams, die Effizienz des Support-Systems und die Kundenzufriedenheit. Die Analyse von Trends in Verbindung mit einer Vorlage für eine Kundenzufriedenheitsumfrage hilft Teams dabei, Probleme zu priorisieren, Verzögerungen zu reduzieren, die Qualität der Problemlösung zu verbessern, Ressourcen intelligenter zuzuweisen und die Supportleistung an die sich wandelnden Erwartungen der Nutzer und die gewünschten Ergebnisse anzupassen.
Ein hoher Rückstand kann darauf hindeuten, dass das IT-Support-Team überlastet ist, was zu verzögerten Lösungszeiten und geringer Kundenzufriedenheit führt.
Die Agentenauslastung misst die Zeit, die ein IT-Support-Agent für Support-bezogene Aktivitäten aufwendet, im Verhältnis zu seiner gesamten verfügbaren Arbeitszeit.
Obwohl es sich größtenteils um ein einfaches Verhältnis handelt, kann die Zahl irreführend sein, wenn nicht definiert wird, was unter „Supportzeit“ zu verstehen ist. Zwei Service Desks, die dieselbe Formel verwenden, können je nach Art der Arbeitserfassung sehr unterschiedliche Auslastungsraten erzielen. Deshalb benötigt diese Kennzahl mehr Kontext als nur die Berechnung.
Nicht alle Arbeiten im Zusammenhang mit der Bearbeitung von Vorfällen erscheinen als direkte Ticketzeit. Untersuchungen, Nachverfolgungen, interne Besprechungen, Eskalationen und administrative Aufgaben können einen erheblichen Teil des Tages in Anspruch nehmen. Wenn Sie nur die direkt in Tickets erfassten Zeiten erfassen, erscheint die Auslastung möglicherweise niedriger als die tatsächliche Arbeitsbelastung. Wenn Sie hingegen alle Aktivitäten unterschiedslos einbeziehen, kann sie künstlich hoch erscheinen.
Mögliche Messansätze sind unter anderem:
Qualitätskennzahlen bewerten die Leistung des Service Desks aus Sicht der Nutzer. Sie konzentrieren sich auf die Konsistenz, Zuverlässigkeit und den wahrgenommenen Wert der Support-Erfahrung. Diese Indikatoren helfen Ihnen zu verstehen, wie gut das Team Probleme löst, ob die Service-Levels den Erwartungen entsprechen und wie Nutzer den Aufwand bewerten, der erforderlich ist, um Hilfe zu erhalten. Zusammen bieten sie einen fundierten Überblick über die Servicequalität, der über reine Produktivität oder Geschwindigkeit hinausgeht.
Der Kundenzufriedenheitsindex misst, wie zufrieden Kunden mit dem IT-Support sind, den sie erhalten. Die CSAT-Kennzahl wird in der Regel ermittelt, indem Kunden gebeten werden, ihre Zufriedenheit mit dem erhaltenen IT-Support zu bewerten, meist auf einer Skala von 1 bis 5 oder 1 bis 10.
Der CSAT ist ein Frühindikator für die Qualität der Kundenerfahrung und hilft dabei, Verbesserungsmöglichkeiten zu identifizieren. Sie sollten den CSAT regelmäßig erfassen, idealerweise nach jeder Interaktion mit Kunden.
Der CSAT spiegelt zudem die Stimmung hinsichtlich des gesamten Kundenerlebnisses wider, nicht nur die Leistung der IT-Abteilung – Verzögerungen durch externe Teams, unklare Prozesse oder Richtlinienentscheidungen können die Bewertung senken, selbst wenn der Mitarbeiter alles korrekt gemacht hat.
Der Net Promoter Score gibt an, wie wahrscheinlich es ist, dass Kunden ein Unternehmen oder dessen Produkte/Dienstleistungen weiterempfehlen. Es handelt sich um eine weit verbreitete Kennzahl, die Unternehmen dabei hilft, die Kundentreue und -zufriedenheit zu verstehen. Darüber hinaus nutzen Unternehmen diese Kennzahl, um die Leistung verschiedener Produkte oder Dienstleistungen zu vergleichen und die Wirksamkeit von Änderungen an Initiativen zur Verbesserung des Kundenerlebnisses zu bewerten.
Die NPS-Kennzahl wird in der Regel ermittelt, indem den Kunden eine einzige Frage gestellt wird: „Auf einer Skala von 0 bis 10: Wie wahrscheinlich ist es, dass Sie unser Unternehmen/unsere Produkte/Dienstleistungen einem Freund oder Kollegen weiterempfehlen?“ Anhand ihrer Antwort werden die Kunden dann in drei Kategorien eingeteilt: Befürworter (9–10), Passive (7–8) und Kritiker (0–6).
Im Gegensatz zur CSAT wird der NPS in der Regel seltener erhoben und spiegelt die gesammelten Erfahrungen wider. Die Nutzer interpretieren die Frage zudem unterschiedlich, je nach Unternehmenskultur, Serviceerwartungen oder der Sichtbarkeit der IT-Abteilung. Ein niedriger NPS spiegelt nicht immer die aktuelle Leistung wider; er kann mit Altlasten oder einer allgemeinen Unzufriedenheit mit der Technologie im Unternehmen zusammenhängen.
Die Einhaltung des Service Level Agreements (SLA) misst , inwieweit ein IT-Support-Team die in seinem SLA festgelegten Ziele und Standards erfüllt. Ein SLA ist eine formelle Vereinbarung zwischen dem IT-Support-Team und seinen Kunden, in der die Dienstleistungen des Unternehmens, das erwartete Supportniveau und der Zeitrahmen für die Behebung von Problemen festgelegt sind.
Nicht alle SLAs spiegeln die tatsächlichen Erwartungen der Nutzer wider. Zu niedrig angesetzte Ziele blähen die Einhaltung auf, während zu strenge Ziele zu ständigen Verfehlungen führen, die die tatsächliche Leistung nicht widerspiegeln. Ein praktischer Ansatz besteht darin, Muster bei Ticketarten, Weiterleitung und Zuständigkeit für Warteschlangen zu analysieren und die Schwellenwerte dann schrittweise anzupassen, anstatt direkt neue Zahlen festzulegen. Es ist außerdem hilfreich, SLAs mit internen OLAs zu vergleichen, damit Support-Teams nicht an Versprechen gebunden sind, die vorgelagerte Gruppen nicht einhalten können.
Auch die Klassifizierung erfordert eine schnelle Überprüfung, da inkonsistente Kategorien die Daten zu Reaktionszeiten und Lösungsquoten verzerren. Ein kurzer Kalibrierungszyklus alle paar Monate sorgt in der Regel dafür, dass die SLAs realistisch bleiben, ohne dabei zu lax zu werden.
Der Customer Effort Score misst , wie einfach es für einen Nutzer war, sein Problem zu lösen oder eine Anfrage abzuschließen. Er konzentriert sich dabei eher auf Reibungspunkte im Prozess als auf das Endergebnis.
Der Customer Effort Score wird in der Regel ermittelt, indem Kunden nach der Interaktion mit dem Support-Team eine einzige Frage gestellt wird: „Wie viel Aufwand mussten Sie betreiben, um Ihre Anfrage zu bearbeiten?“ Die Kunden werden dann gebeten, ihre Erfahrung auf einer Skala von „sehr einfach“ bis „sehr schwierig“ zu bewerten.
Der CES wird stark von der Prozessgestaltung beeinflusst. Selbst eine hervorragende Leistung der Mitarbeiter kann Workflows nicht ausgleichen, die mehrere Genehmigungen, wiederholte Angaben, langwierige Formulare oder Übergaben erfordern. Daher ist der CES eher ein sensibler Indikator für strukturelle Reibungsverluste als für die individuelle Leistung.
Leistungskennzahlen geben Aufschluss darüber, wie schnell und effektiv das Support-Team Aufgabenbearbeitet . Sie helfen Ihnen, die Reaktionsgeschwindigkeit, Lösungsmuster und das Arbeitsaufkommen zu verstehen.
Erste Antwortzeit ist die Zeit, die ein IT-Support-Team benötigt, um auf die erste Supportanfrage eines Kunden zu reagieren. Dabei wird nicht erfasst, wie lange es dauert, das Problem zu beheben. Es handelt sich um einen wichtigen Leistungsindikator, der zur Bewertung der Reaktionsfähigkeit von IT-Support-Teams herangezogen wird.
Die FRT-Spannen hängen vom Kanal ab (E-Mail, Chat, Portal). Sie sollten die natürlichen Reaktionsmuster überprüfen und das Ziel so anpassen, dass es realistische Erwartungen widerspiegelt, ohne überhöht zu sein. Wenn das Team die Weiterleitungsregeln ändert oder auf neue Kanäle umstellt, sollten Sie das Ziel erneut überprüfen, da sich die Basiswerte verschieben können.
Die First Contact Resolution bezeichnet die Fähigkeit eines IT-Supportteams, Kundenprobleme oder -anfragen bereits beim ersten Kontakt des Kunden mit dem Supportteam zu lösen, ohne dass eine weitere Bearbeitung erforderlich ist.
Bei der Festlegung von FCR-Zielen sollte geprüft werden, welche Kategorien tatsächlich beim ersten Kontakt gelöst werden können, und es sollten Erwartungen pro Kategorie statt eines pauschalen Gesamtziels festgelegt werden. Es ist außerdem hilfreich zu beobachten, ob die Supportqualität sinkt, wenn ein höherer FCR angestrebt wird; sollten schnelle Lösungen zu einem Anstieg der Wiedereröffnungsraten führen, muss das Ziel angepasst werden.
Die Zeit bis zur Lösung (TTR) misst, wielange es dauert, ein Ticket ab dem Zeitpunkt seiner Eröffnung vollständig zu lösen.
Um die TTR zu berechnen, ziehen Sie den Zeitpunkt, zu dem der Kunde die Anfrage gestellt hat, vom Zeitpunkt der Lösung des Problems ab.
Die TTR misst die gesamte Zeit, die zur Lösung des Problems benötigt wird, einschließlich etwaiger Folgekontakte oder Eskalationen.
Die TTR variiert stark je nach Art des Vorfalls, sodass ein einzelner Richtwert die Leistung oft verzerrt darstellt. Die Festlegung eines zu engen globalen Ziels führt zwangsläufig zu ständigen Ausnahmen, während ein zu weit gefasstes Ziel Verzögerungen in den Kategorien verschleiert, auf die es tatsächlich ankommt. Der zuverlässigste Ansatz besteht darin, die historischen Lösungszeiträume nach Kategorie oder Schweregrad zu betrachten und Bandbreiten festzulegen, die die tatsächlichen Schwankungen widerspiegeln.
Die durchschnittliche Bearbeitungszeit misst die durchschnittliche Zeit, die ein IT-Supportmitarbeiter benötigt, um eine Anfrage zu bearbeiten, einschließlich der Zeit für das Gespräch mit dem Kunden und aller damit verbundenen Aufgaben wie Recherche oder Dokumentation.
Es ist wichtig, die AHT mit anderen Kennzahlen, insbesondere mit Indikatoren für die Supportqualität wie der Kundenzufriedenheit, abzugleichen und sie eher als Trendkennzahl denn als festes Ziel zu betrachten, um Verhaltensverzerrungen zu vermeiden.
Beispielsweise kann ein Mitarbeiter des IT-Supports Anfragen zwar schnell bearbeiten. Wenn er jedoch keine effektiven Lösungen anbietet oder die Kunden mit dem Kontakt nicht zufrieden sind, liefert die AHT allein möglicherweise kein vollständiges Bild der Qualität der IT-Support-Dienstleistungen.
Die Eskalationsrate ist der prozentuale Anteil der Anfragen, die an höhere Support- oder Managementebenen weitergeleitet werden. Sie misst, wie häufig Probleme vom ersten Support-Team nicht gelöst werden können und weitere Maßnahmen erfordern.
Die Eskalationsrate liefert nur dann ein aussagekräftiges Bild, wenn die Weiterleitungslogik stabil ist. Jede Änderung der Triage-Regeln, der Warteschlangenstruktur oder der Teamzuständigkeiten kann die Rate von einem Tag auf den anderen verändern, wodurch die Kennzahl schlechter oder besser aussieht, ohne dass sich die tatsächliche Leistung verändert hat. Prüfen Sie bei der Anpassung von Schwellenwerten, ob Eskalationen auf Qualifikationslücken, eine falsche Kategorisierung oder strenge Berechtigungsgrenzen zurückzuführen sind. Legen Sie akzeptable Bereiche pro Kategorie oder Schweregrad fest, anstatt einen einheitlichen Wert anzuwenden. Wenn die Quote zu stark sinkt, stellen Sie sicher, dass Fälle nicht nur deshalb auf Stufe 1 belassen werden, um die Kennzahl zu schützen.
Der Schweregrad eines Vorfalls misst die Auswirkungen eines IT-Vorfalls auf den Betrieb, die Dienste oder die Kunden des Unternehmens. Er kategorisiert Vorfälle anhand des Ausmaßes der Störung oder der Auswirkungen, die sie auf das Geschäft haben.
Im Allgemeinen gibt es vier Schweregrade für Vorfälle:
Um einem Vorfall einen Schweregrad zuzuweisen, müssen Sie sich an dessen Auswirkungen und Dringlichkeit orientieren. Dabei können Sie Faktoren wie die Anzahl der betroffenen Nutzer, die Kritikalität des Systems oder Dienstes sowie die potenziellen Auswirkungen auf den Umsatz berücksichtigen.
Schweregraddaten sind nur dann aussagekräftig, wenn die Kategorien einheitlich angewendet werden. Sind die Schwellenwerte vage definiert, kommt es in der Warteschlange zu einer Über- oder Unterbewertung des Schweregrads, was die TTR, die SLA-Erfüllung und die Ressourcenzuweisung verzerrt. Eine regelmäßige Überprüfung von Beispielen pro Kategorie trägt dazu bei, das Modell stabil zu halten.
Finanzkennzahlen zeigen die wirtschaftlichen Auswirkungen des Betriebs des Service Desks auf. Sie helfen dabei, die Kosten für die Bearbeitung von Anfragen zu quantifizieren, die interne Leistung mit Benchmarks zu vergleichen und Budgetentscheidungen in Bezug auf Personal, Tools und Prozessverbesserungen zu unterstützen.
Die Kosten pro Ticket ( ) sind die durchschnittlichen Kosten für die Bearbeitung eines IT-Support-Tickets. Sie helfen Unternehmen dabei, die finanziellen Auswirkungen ihrer IT-Support-Prozesse zu verstehen, und können als Grundlage für Entscheidungen zur Ressourcenzuweisung und Effizienz dienen.
Die Teams entscheiden selbst, ob indirekte Kosten (Schulungen, Software-Abonnements, interne Verrechnungen) einbezogen werden sollen. Wichtig ist, das Modell konsistent zu halten, damit die Trends zuverlässig bleiben.
Bei einer langfristigen Beobachtung können sich daraus Erkenntnisse über die Wirksamkeit von Prozessänderungen oder Technologieinvestitionen gewinnen lassen. Wird beispielsweise ein neues Helpdesk-Tool oder ein neuer Prozess eingeführt und sinken die Kosten pro Ticket im Laufe der Zeit, kann dies als Zeichen dafür gewertet werden, dass die Investition erfolgreich war.
ROI steht für „Return on Investment“ und misst die Effizienz einer Investition. Unternehmen nutzen diesen Wert, um die finanzielle Rendite von Investitionen in IT-Infrastruktur, Software oder andere technologiebezogene Projekte zu bewerten.
Der Nutzen kann direkt (Reduzierung der Arbeitsstunden) oder indirekt (höhere Erstlösungsquote, wodurch Betriebsausfälle reduziert werden) sein. Wichtig ist, den Nutzen im Vorfeld zu definieren, damit sich die ROI-Berechnungen nicht auf nachträgliche Annahmen stützen.
Durch die langfristige Verfolgung des ROI können Unternehmen feststellen, ob die Investition erfolgreich war und ob weitere Investitionen in ähnliche Technologien gerechtfertigt sind.
KI- und Deflection-Kennzahlen erfassen, wie viele Supportanfragen ohne Beteiligung eines Mitarbeiters gelöst werden – durch Self-Service, Wissensdatenbanken und virtuelle Agenten. Sie zeigen, wo die Automatisierung die Nachfrage auffängt, wie effektiv Nutzer Probleme selbst lösen und welche Anfragen in der Warteschlange niemals einen Mitarbeiter erreichen. Da Self-Service und KI-gestützte Problemlösungen einen immer größeren Anteil der Supportaktivitäten einnehmen, zeigen diese Kennzahlen, ob diese Verlagerung die Arbeitsbelastung der Mitarbeiter verringert oder sie lediglich auf nachgelagerte Bereiche verlagert.
Die Ticket-Abwehrquote misst den Anteil potenzieller Tickets, die durch Self-Service gelöst werden, bevor sie einen Mitarbeiter erreichen. Sie spiegelt wider, wie effektiv Wissensdatenbanken, Portale und virtuelle Agenten die Nachfrage auffangen, die andernfalls in die Warteschlange gelangen würde.
Eine Umleitung ist nur dann aussagekräftig, wenn die umgeleitete Interaktion das Problem des Nutzers tatsächlich löst. Der Aufruf einer Wissensdatenbank oder eine Chatbot-Sitzung, die ohne Antwort endet, kann als Umleitung gewertet werden, während das zugrunde liegende Problem weiterhin ungelöst bleibt, was die Quote künstlich in die Höhe treibt. Kombinieren Sie die Umleitung mit einem Follow-up-Signal – einem erneuten Kontakt innerhalb eines kurzen Zeitraums, einer Antwort auf die Frage „War das hilfreich?“ oder einem nachfolgenden Ticket zum gleichen Thema –, um sicherzustellen, dass vermiedene Tickets tatsächlich gelöste Probleme widerspiegeln.
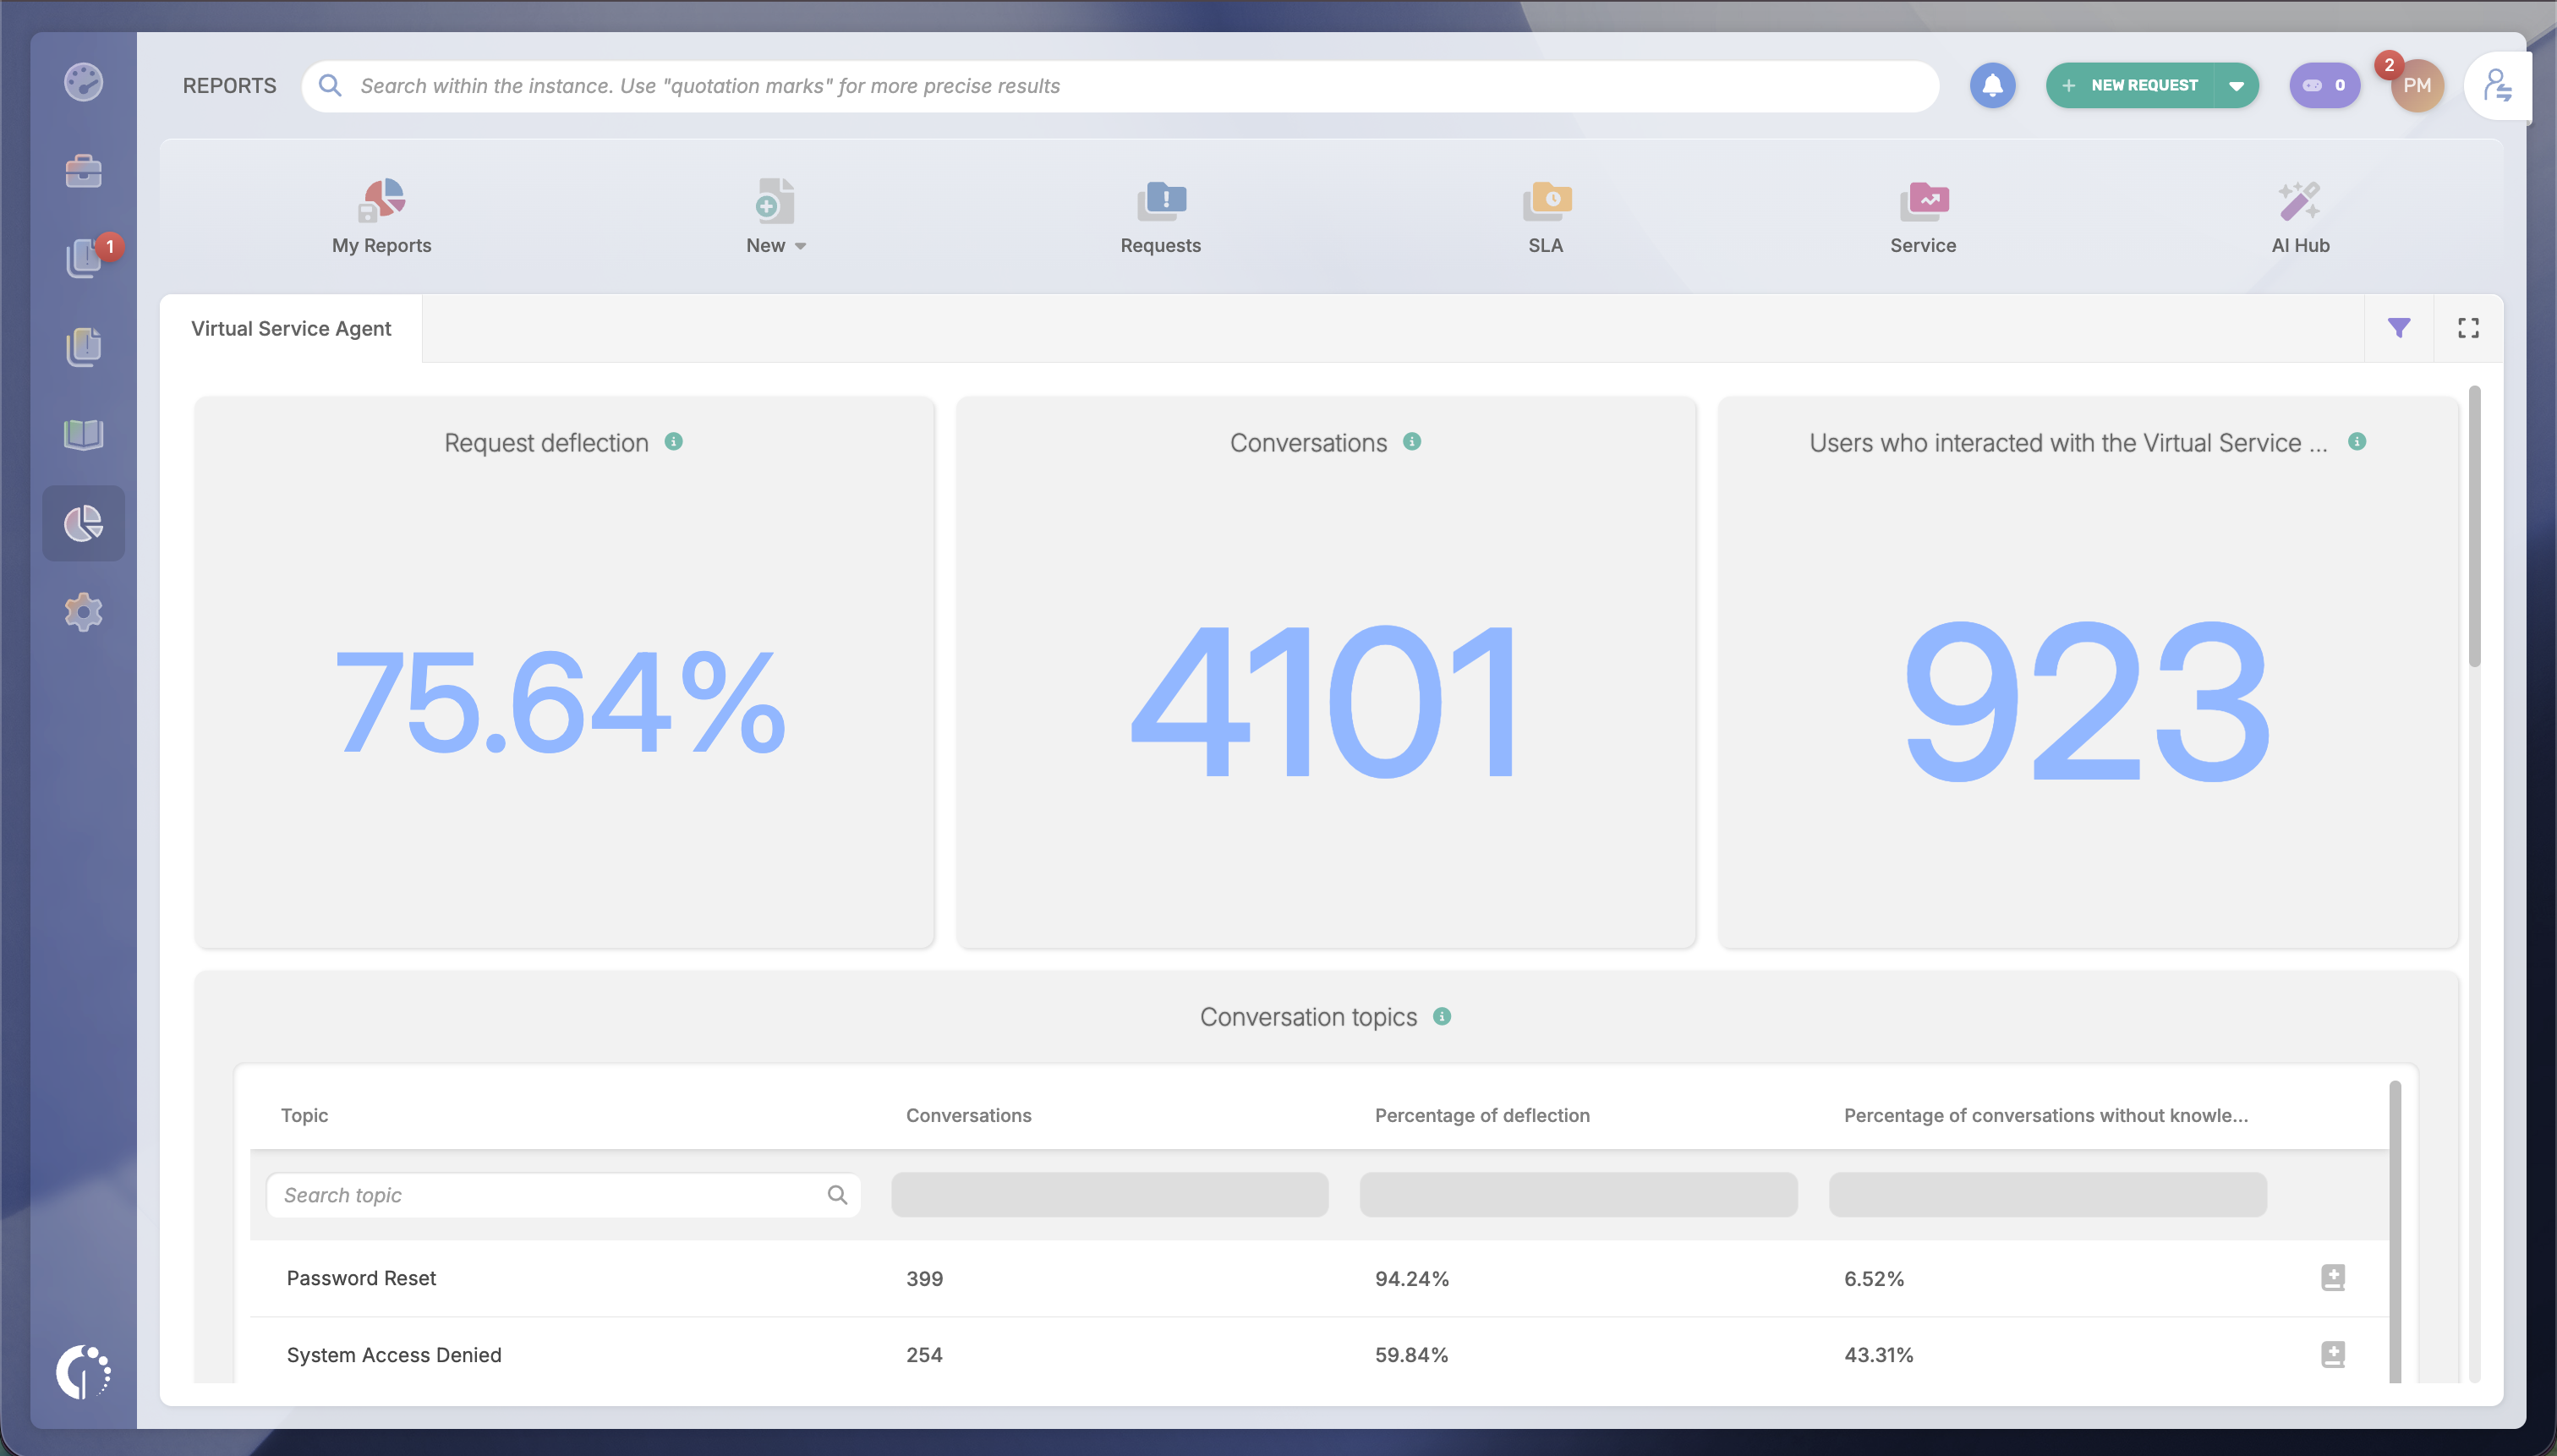
Die Self-Service-Erfolgsquote misst den Anteil der Nutzer, die ihr Problem über Self-Service-Kanäle lösen, nachdem sie dort begonnen haben. Sie isoliert die Effektivität der Wissensdatenbank und des Portals vom Gesamtverkehr und zeigt, ob die Inhalte, die Nutzer finden, ihre Anfrage tatsächlich abschließen.
Die Zuordnung ist die größte Herausforderung. Ein Nutzer könnte einen Artikel lesen, die Seite verlassen und das Problem anderweitig lösen oder die Sitzung abbrechen und erst Stunden später ein Ticket eröffnen. Die Festlegung eines Lösungsfensters und die Verknüpfung von Sitzungen mit nachfolgenden Kontakten sorgen für eine fundierte Messgröße. Niedrige Erfolgsraten deuten in der Regel auf inhaltliche Lücken oder Suchprobleme hin. Segmentieren Sie die Kennzahl daher nach Themen, um festzustellen, in welchen Bereichen die Wissensdatenbank unzureichend ist und wo neue Artikel die meisten Anfragen schließen würden.
Die Abwicklungsrate virtueller Agenten misst den Anteil der Konversationen, die ein virtueller Agent von Beginn bis zur Lösung bearbeitet, ohne an einen menschlichen Mitarbeiter weiterzuleiten. Sie zeigt, wie viel Konversationsaufkommen die Automatisierung auffängt und wo sich Eskalationsmuster konzentrieren.
Eine hohe Abwicklungsquote ist nur dann aussagekräftig, wenn die abgewickelten Gespräche mit einem zufriedenen Nutzer enden. Sitzungen, die ins Stocken geraten, sich im Kreis drehen oder abgebrochen werden, können als abgewickelt gelten, obwohl sie die Nutzer in einen anderen Kanal drängen, wodurch die tatsächliche Eskalationslast verschleiert wird. Verfolgen Sie die Abwicklungsquote zusammen mit der Zufriedenheit nach dem Gespräch und den Wiederkontaktquoten, um sicherzustellen, dass eine steigende Zahl tatsächlich auf gelöste Anliegen hindeutet.
Die automatisierte Lösungsquote misst den Anteil der Tickets, die nach ihrer Erstellung durch automatisierte Workflows ohne Eingreifen eines Mitarbeiters gelöst werden. Sie erfasst den Wert der nach der Erfassung angewandten Automatisierung – Weiterleitung, Kategorisierung und Schließung durch Regeln oder KI – und unterscheidet diesen von der Umleitung, die vor der Erstellung eines Tickets erfolgt.
Die Grenze zwischen automatisierungsgestützter und vollständig automatisierter Lösung prägt diesen Wert. Ein Ticket, das von einer Automatisierung weitergeleitet und angereichert wird, bevor ein Mitarbeiter es schließt, unterscheidet sich von einem Ticket, das von Anfang bis Ende ohne menschliches Zutun geschlossen wird. Legen Sie vor der Meldung der Quote fest, was als automatisiert gilt, und halten Sie die Definition über alle Zeiträume hinweg konsistent, damit Trends vergleichbar bleiben. Eine Segmentierung nach Anfragetyp zeigt, welche Kategorien sich besonders gut für die Automatisierung eignen und welche weiterhin auf menschliches Urteilsvermögen angewiesen sind
Ein solides Messmodell hilft IT-Support-Teams dabei, Nachfrage, Servicequalität und Betriebskosten zu verstehen. Helpdesk-Leistungskennzahlen bieten Führungskräften zudem eine klare Möglichkeit, die tägliche Arbeit mit übergeordneten Geschäftszielen zu verknüpfen. Bei konsequenter Erfassung dienen sie als Leitfaden für Prozessanpassungen, Personalentscheidungen und Serviceverbesserungen.
Ein strukturiertes Konzept sorgt dafür, dass die Kennzahlen aussagekräftig bleiben und verhindert, dass Daten zu bloßem Rauschen werden. Vier praktische Schritte können Ihnen dabei helfen, einen soliden Prozess zu etablieren:
InvGate Service Management macht es einfach, die Nachverfolgung von Kennzahlen zu automatisieren und manuelle Berichterstellung überflüssig zu machen.
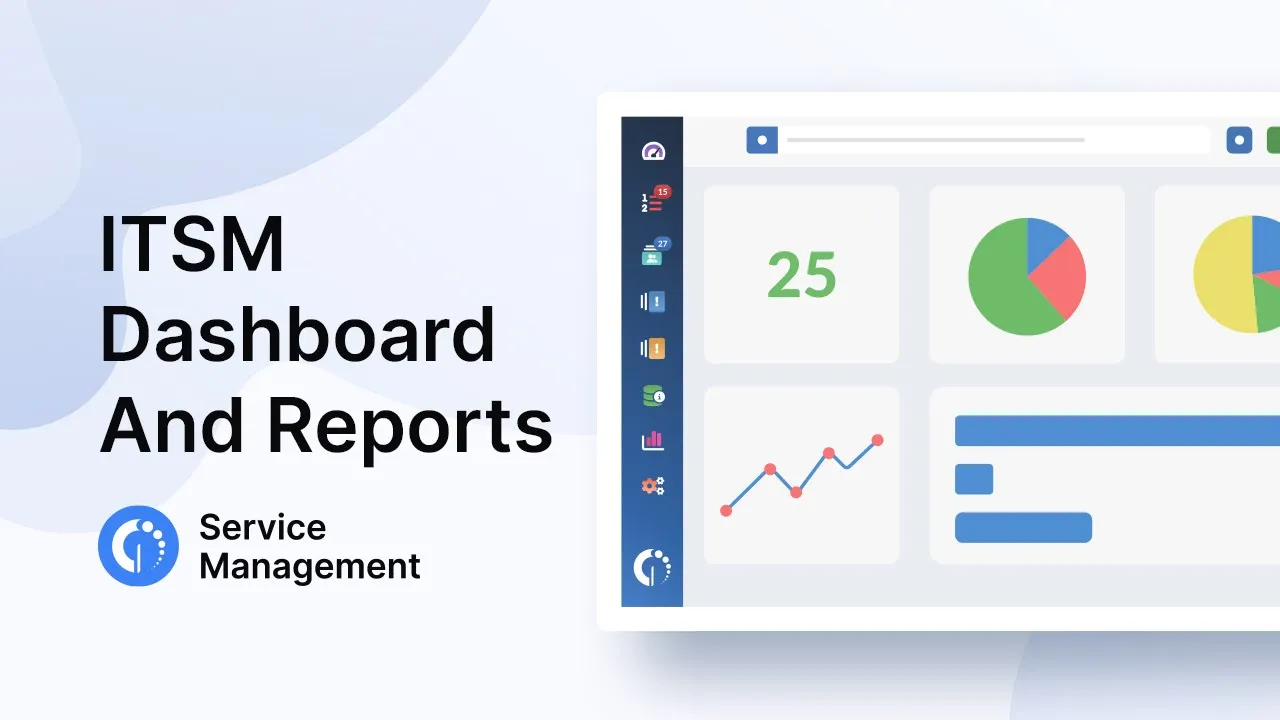
Dashboards in InvGate Service Management lassen sich per Mausklick und Drag-and-Drop konfigurieren.
Da InvGate Service Management mehrere Helpdesks und unterschiedliche Zugriffsebenen unterstützt, gilt dies auch für die Analyseebene – sie bietet Berichtstools für Koordinatoren und Administratoren in jedem Zuständigkeitsbereich. Dadurch wird das Problem von Einheits-Dashboards beseitigt, die jedem alles anzeigen und für niemanden nützlich sind.
Dashboards können auch mit Beteiligten außerhalb des Service-Desk-Teams geteilt werden, wodurch Führungskräfte in Echtzeit Einblick in die Service-Leistung erhalten, ohne Zugriff auf die gesamte Plattform zu benötigen.
Hier findet die Umwandlung von Kennzahlen in KPIs auf operativer Ebene statt.
In InvGate Service Management wandeln SLA-Richtlinien Kennzahlen wie FRT und TTR in Ziele mit Alarmlogik um. Sie konfigurieren den Schwellenwert – zum Beispiel „P2-Vorfälle müssen innerhalb von 8 Stunden behoben werden“ – und das System überwacht die Einhaltung in Echtzeit. Wenn sich ein Ticket der SLA-Grenze nähert, kann die Plattform automatisch eine Benachrichtigung auslösen, das Ticket neu zuweisen, es an die nächste Ebene eskalieren oder seine Priorität ändern.
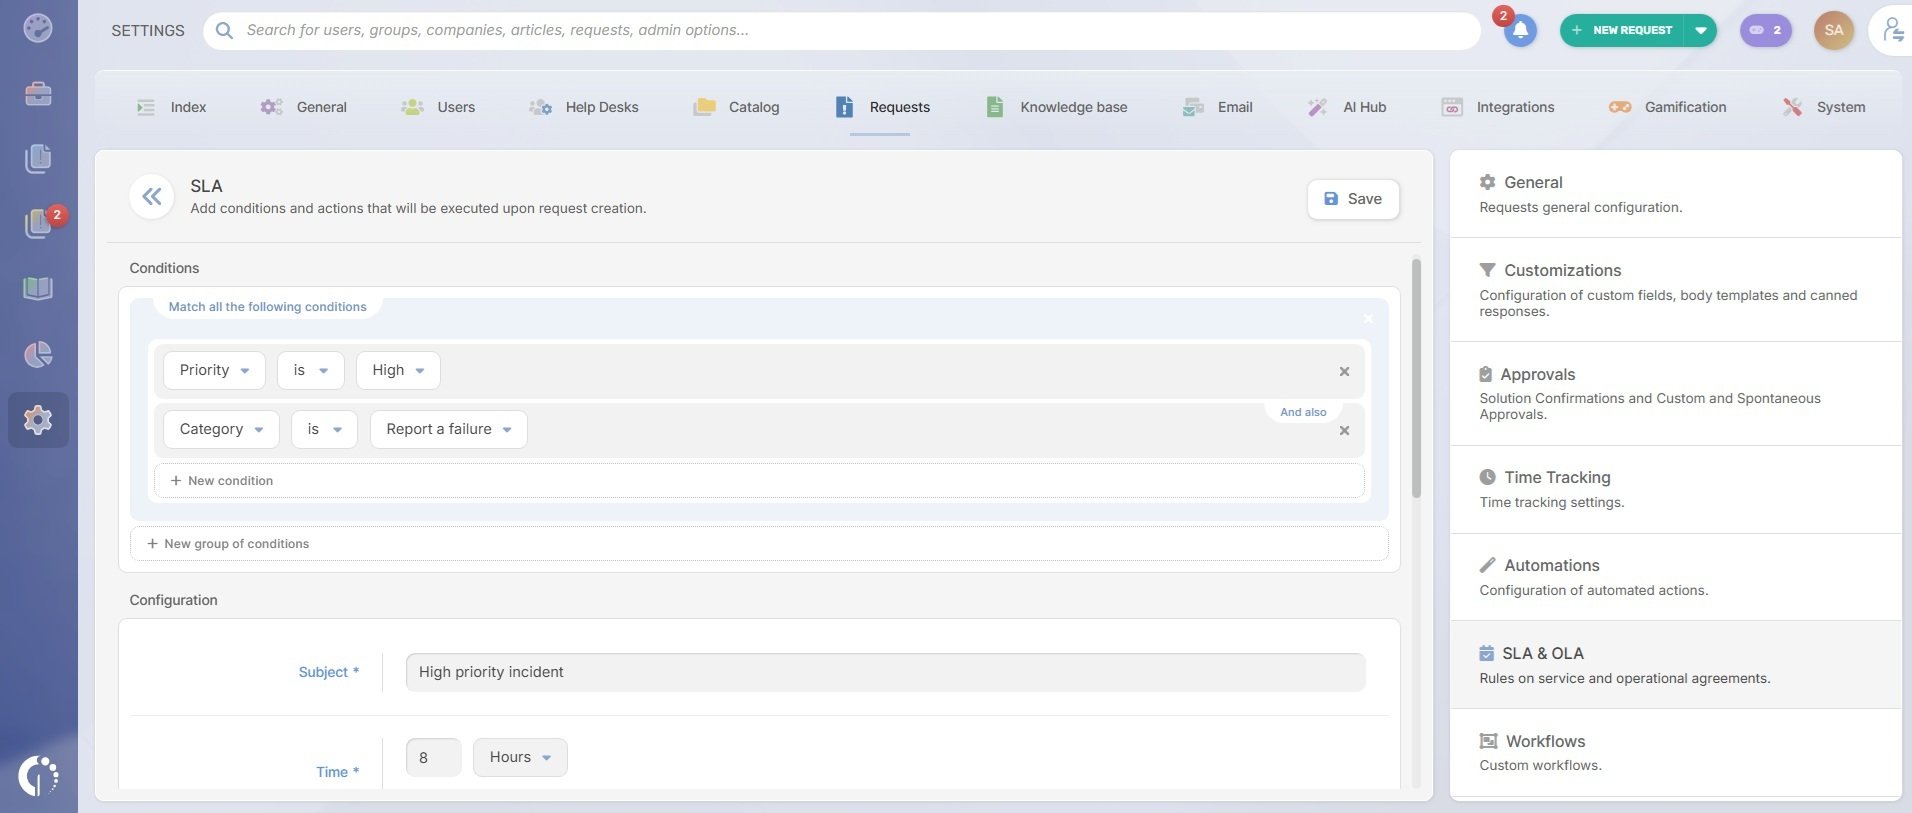
Berichte lassen sich so konfigurieren, dass sie genau die Kennzahlen enthalten, die für Ihren Service Desk von Bedeutung sind – wie beispielsweise FRT, SLA-Einhaltung oder Kosten pro Ticket.
Um einen Bericht einzurichten, öffnen Sie „Berichte“ → „Anfragen“ → „Neuer Bericht“, wählen Sie die Kennzahlen aus, geben Sie einen Datumsbereich an und wenden Sie die gewünschten Filter an. Nach dem Speichern können Sie über das Uhrensymbol eine automatische Zustellung planen und die Häufigkeit sowie die Empfänger auswählen. Berichte können sowohl an lizenzierte als auch an nicht lizenzierte Benutzer gesendet werden, was nützlich ist, wenn Sie andere Teams oder Führungskräfte über den aktuellen Stand informieren möchten.
Dashboards bieten einen Echtzeit-Überblick über die Leistung. Sie lassen sich mit Widgets für Rückstände, Eskalationen, Reaktionszeiten oder Finanzkennzahlen anpassen, um den täglichen Betrieb zu überwachen. Diese Ansichten helfen dabei, Abweichungen frühzeitig zu erkennen und eine schnellere Entscheidungsfindung zu unterstützen.
Möchten Sie sehen, wie das in der Praxis aussieht? Fordern Sie eine kostenlose 30-Tage-Testversionan und entdecken Sie InvGate Service Management und all seine Funktionen.
Die Erfassung von 15 Kennzahlen bedeutet nicht, dass 15 KPIs gepflegt werden müssen. Der Unterschied ist wichtig: Kennzahlen dienen der Diagnose; KPIs fördern die Verantwortlichkeit und die Verbesserung.
Der empfohlene Bereich für die meisten Teams liegt bei 5–7 KPIs. Bei weniger als 5 geht die Abdeckung der vier Bereiche verloren. Bei mehr als 7 wird es schwierig zu erkennen, an welchen Hebeln man ansetzen muss, wenn die Leistung nachlässt.
Hier ist ein dreistufiges Rahmenkonzept, mit dem Sie die oben genannten Kennzahlen in KPIs umwandeln können, auf deren Grundlage Ihr Team Maßnahmen ergreifen kann.
Beginnen Sie mit dem Ergebnis, das das Unternehmen im aktuellen Zyklus beeinflussen muss, und nicht mit den Kennzahlen. Beispiele:
Jedes Ziel ist einer Gruppe von Kennzahlen zugeordnet. Die KPIs sind jene Kennzahlen, denen ein Zielwert zugewiesen ist.
Ein KPI ohne Zielwert ist immer noch eine Kennzahl. Legen Sie für jeden ausgewählten Indikator fest, wo die Leistung derzeit steht (die Ausgangsbasis) und wo sie innerhalb des Überprüfungszyklus stehen soll (das Ziel). Die Differenz zwischen beiden Werten definiert das Verbesserungsziel. Hinweise zur Festlegung realistischer und an den Geschäftserwartungen ausgerichteter SLA-basierter Zielwerte finden Sie unter „Erstellung effektiver ITSM-SLAs“.
Verschiedene KPIs unterliegen unterschiedlichen Überprüfungsrhythmen:
Dieser Rhythmus verhindert die häufige Falle, alles mit derselben Häufigkeit zu überprüfen: Entweder werden sich schnell ändernde Signale (operative Kennzahlen) übersehen oder es kommt zu Überreaktionen auf kurzfristige Schwankungen (strategische Kennzahlen).
Was sind die wichtigsten Helpdesk-Kennzahlen?
Die wichtigsten Kennzahlen für die meisten Teams sind FCR (First Contact Resolution), FRT (First Response Time), SLA-Einhaltungsquote und CSAT. Zusammen decken sie Geschwindigkeit, Qualität der Lösung, Einhaltung von Serviceversprechen und die vom Nutzer empfundene Zufriedenheit ab. Welche dieser Kennzahlen als KPIs priorisiert werden, hängt von dem spezifischen Geschäftsziel ab, auf das das Team im aktuellen Bewertungszyklus Einfluss nehmen muss – ein Team, das an Kostensenkungen arbeitet, wird die Auslastung der Mitarbeiter und die Kosten pro Ticket anders gewichten als ein Team, das sich auf die Verbesserung der Nutzererfahrung konzentriert.
Was ist der Unterschied zwischen Helpdesk-Kennzahlen und KPIs?
Eine Kennzahl ist ein operativer Datenpunkt: Sie misst, was im Supportprozess geschehen ist – zum Beispiel die durchschnittliche Zeit bis zur Lösung. Ein KPI ist eine Kennzahl, die an ein bestimmtes Ziel mit einer definierten Vorgabe geknüpft ist – zum Beispiel die Lösung von 90 % der P2-Vorfälle innerhalb von 8 Stunden. Alle KPIs nutzen Kennzahlen, aber nicht alle Kennzahlen sind KPIs. Diese Unterscheidung ist aus operativer Sicht wichtig: Kennzahlen bieten eine diagnostische Abdeckung über den gesamten Service Desk hinweg; KPIs fördern Verantwortlichkeit, Warnmeldungen und Verbesserungszyklen.
Wie misst man die Helpdesk-Leistung?
Indem man Kennzahlen aus den vier Bereichen kombiniert: Produktivität (Ticketvolumen, Rückstand, Auslastung der Agenten), Qualität (CSAT, NPS, SLA-Einhaltung, CES), Leistung (FRT, TTR, FCR, Rate der wiedereröffneten Tickets) und Kosten (Kosten pro Ticket, Selbstbedienungs-Lösungsrate). Die Messung nur einer Kategorie liefert ein unvollständiges Bild – ein Team mit niedriger TTR, aber hohen Kosten pro Ticket und niedriger CSAT-Zufriedenheit schneidet insgesamt nicht gut ab. Die vier Kategorien zusammen bieten die nötige Ausgewogenheit, um fundierte operative und strategische Entscheidungen zu treffen.
Was ist eine gute FCR-Rate für einen Service Desk?
Laut der Service Quality Measurement Group liegt der Branchenstandard für eine solide FCR-Rate zwischen 70 % und 79 %. Raten unter 70 % deuten darauf hin, dass ein erheblicher Anteil der Tickets mehrere Interaktionen erfordert, um gelöst zu werden, was sich direkt auf die CSAT auswirkt und die Kosten pro Kontakt in die Höhe treibt. Raten über 79 % sind erreichbar, hängen jedoch stark von der Komplexität des Anfragemixes und der Ausgereiftheit der Self-Service- und Wissensdatenbank-Infrastruktur ab.

