




Um backlog de chamados crescente pressiona o desempenho do SLA (Acordo de Nível de Serviço), a capacidade dos agentes e os tempos de resolução. Para zerá-lo de forma eficaz, é preciso identificar o que está provocando o acúmulo, separar o trabalho urgente das solicitações rotineiras e retirar da fila o trabalho desnecessário.
A seguir, mostramos uma abordagem prática para reduzir o backlog: fazer a triagem da fila, reavaliar prioridades, automatizar o trabalho repetitivo e resolver chamados em lote quando fizer sentido. Também abordamos os processos e as automações que ajudam a evitar que o backlog volte a se formar, incluindo em que pontos uma ferramenta como o InvGate Service Management pode apoiar cada etapa.
O backlog de chamados deve ser tratado como um problema operacional, e não como uma corrida para fechar o maior número possível de tickets. A prioridade é recuperar o controle da fila sem comprometer a qualidade do serviço, ao mesmo tempo em que se identificam os fatores que fizeram o trabalho se acumular. O processo começa com um diagnóstico claro, seguido de priorização, resolução e medidas para evitar que as mesmas condições formem o backlog novamente.
Comece com uma visão clara da fila antes de fazer mudanças. Segmente o backlog por idade, prioridade, status, responsável e tipo de solicitação. O objetivo é distinguir o trabalho que exige resolução ativa dos chamados que podem ser fechados, consolidados ou retirados da fila.
Procure especificamente por:
O relatório do backlog também deve mostrar como o volume de chamados varia por idade e prioridade. Isso dá à equipe uma linha de base para medir se o backlog está de fato diminuindo e ajuda a identificar as fontes de demanda contínua.
A idade, sozinha, não deve definir o que é atendido primeiro. Um chamado aberto há meses pode ter pouco impacto no negócio, enquanto um problema novo que afeta um serviço crítico pode exigir atenção imediata.
Aplique os níveis de prioridade do seu help desk com base em impacto e urgência, e depois compare as prioridades resultantes com as metas de SLA. Sinalize os chamados que estão perto de uma violação, que já estão fora do SLA ou que afetam serviços críticos para o negócio.
Depois de priorizar a fila, separe os chamados de acordo com a ação que cada um exige. Nem todo item do backlog precisa do mesmo processo de resolução.
As ações em massa e os modelos de resposta reutilizáveis do InvGate Service Management podem reduzir o esforço manual de processar grupos de chamados semelhantes. As solicitações resolvidas também podem ser vinculadas a artigos da base de conhecimento relevantes, oferecendo aos usuários um caminho de autoatendimento quando o mesmo problema voltar a acontecer.
O backlog fica mais difícil de controlar quando os agentes gastam tempo decidindo para onde os tickets devem ir ou monitorando filas em busca de trabalho atrasado. As regras de encaminhamento e escalonamento podem transferir esse trabalho administrativo para a plataforma de Gerenciamento de Serviços.
Os recursos de IA da InvGate podem acrescentar mais uma camada de apoio à decisão. As sugestões de colaboradores especialistas analisam solicitações semelhantes e recomendam pessoas com experiência relevante. O escalonamento inteligente de solicitações usa dados históricos de casos para identificar solicitações que podem estar em risco de violar o SLA e antecipar o escalonamento.
Zerar a fila resolve o volume imediato. Evitar um novo acúmulo exige olhar para a demanda que entra na fila, para o trabalho que consome a capacidade dos agentes e para os problemas que geram solicitações repetidas.
Parte do volume do backlog vem de solicitações que os usuários poderiam resolver sem a participação de um agente. Uma operação de autoatendimento útil dá aos usuários acesso ao conhecimento relevante e uma forma clara de concluir solicitações comuns sem abrir um ticket.
O InvGate Service Management combina um portal de autoatendimento com uma base de conhecimento para que os usuários encontrem informações e enviem solicitações estruturadas. Seu Virtual Service Agent com IA leva esse recurso ao portal de autoatendimento e aos canais em que as pessoas já trabalham (Microsoft Teams, WhatsApp e Slack), sugerindo artigos de conhecimento e categorias de solicitação relevantes durante a interação.
O objetivo não é simplesmente oferecer mais uma forma de abrir chamados. O autoatendimento deve reduzir o número de solicitações que exigem a intervenção de um agente.

Acompanhe, de forma consistente, um pequeno conjunto de métricas de help desk:
Analisar esses indicadores em conjunto ajuda a distinguir um backlog temporário de um problema de capacidade ou de demanda. Se o volume de entrada supera de forma consistente a capacidade de resolução, zerar a fila atual trará apenas um alívio temporário.
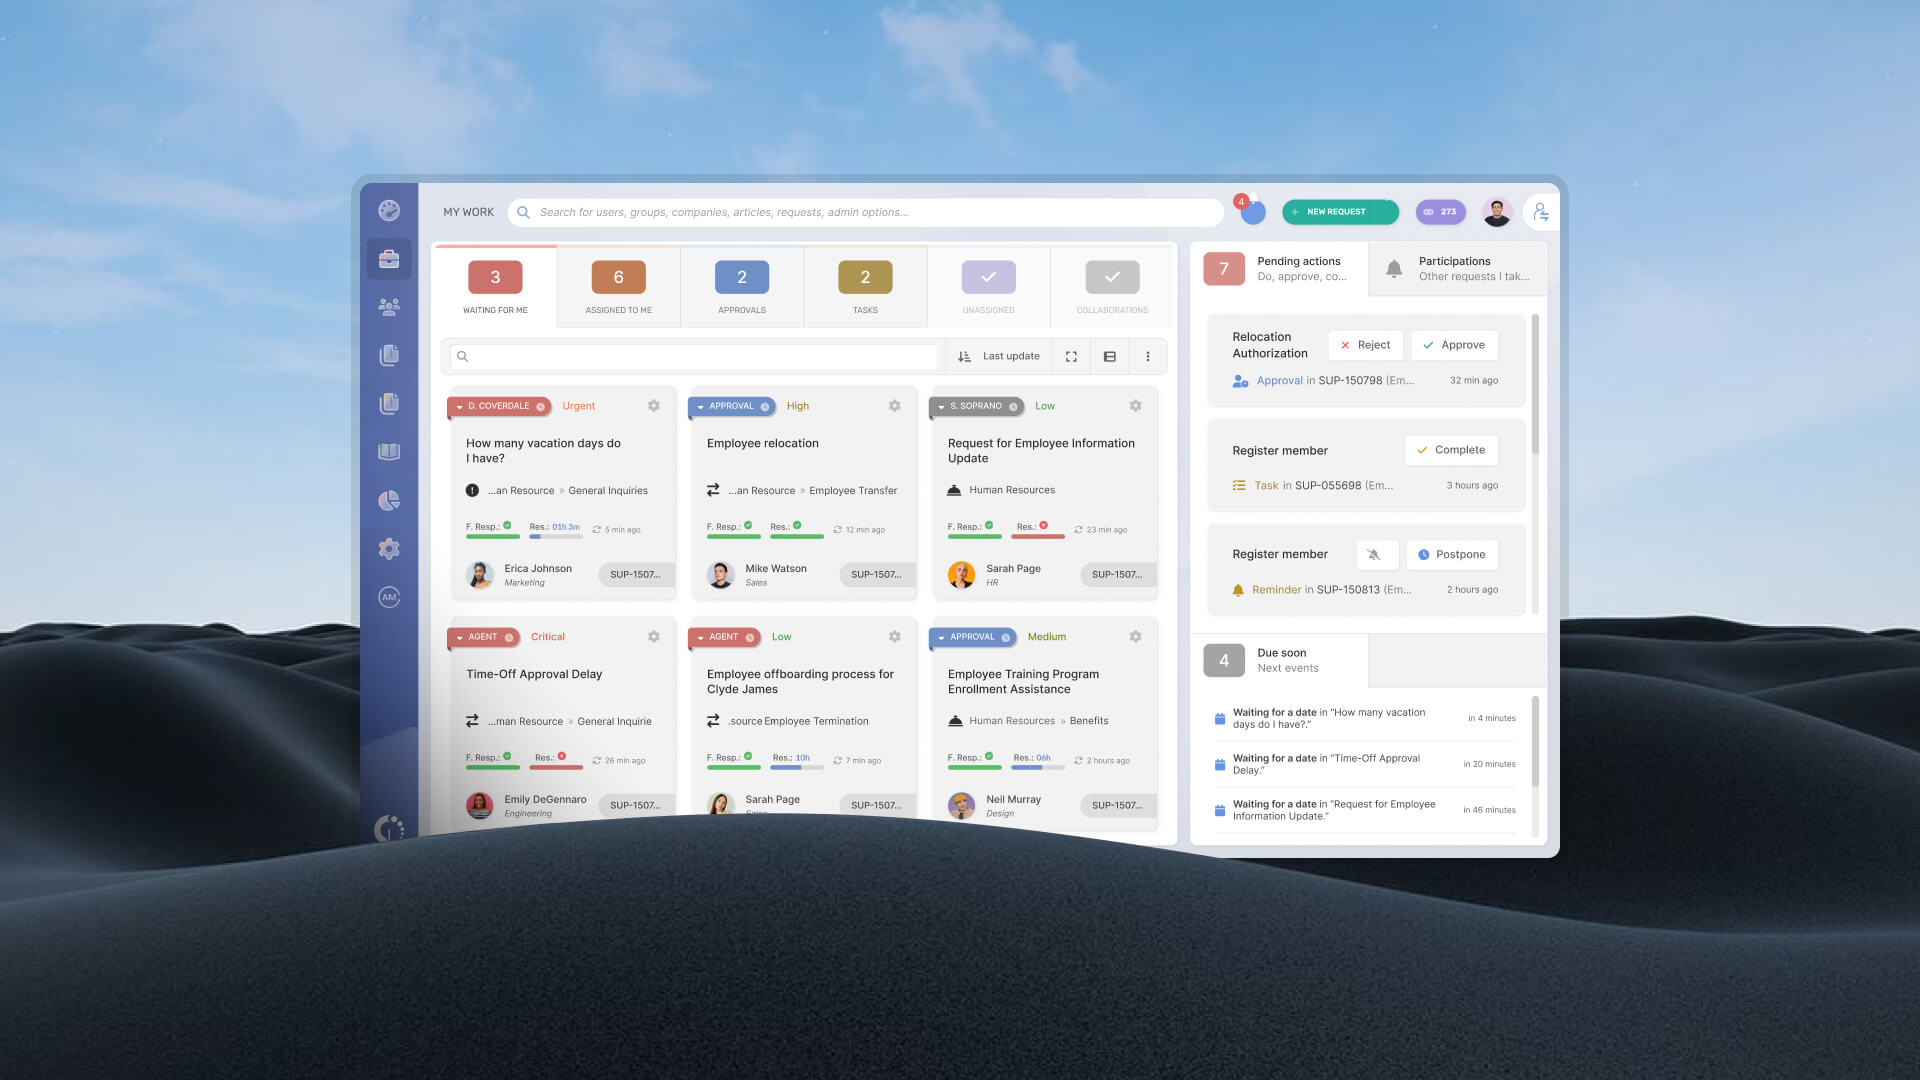
No InvGate Service Management, as visualizações personalizadas e os painéis de análise podem segmentar a fila por diferentes critérios, como idade, prioridade e status, oferecendo às equipes uma visão atual da composição do backlog.
Incidentes recorrentes podem continuar alimentando o backlog mesmo depois que a fila foi zerada. Agrupe os chamados relacionados, identifique as causas comuns e use a análise de causa raiz para determinar quais problemas justificam uma ação corretiva permanente.
O InvGate Service Management pode ajudar a identificar padrões nos dados de incidentes. Sua detecção de problemas comuns com IA analisa solicitações relacionadas para revelar problemas recorrentes, dando às equipes uma base para investigar e resolver a causa de fundo.
Cada solicitação repetida é uma possível lacuna de conhecimento. Quando um chamado revela uma dúvida que os usuários provavelmente terão de novo, avalie se a resolução deve entrar na base de conhecimento. Mantenha os artigos atualizados, remova orientações obsoletas e conecte os artigos relevantes aos fluxos de solicitação do autoatendimento.
O InvGate Service Management reduz a parte manual desse trabalho. A geração de artigos de conhecimento com IA cria, em segundos, o rascunho de um artigo a partir de um chamado resolvido para que um agente revise, edite e aprove.
Knowledge Discovery vai um passo além: analisa os chamados fechados recentemente, identifica resoluções recorrentes que ainda não estão documentadas e gera Snippets de conhecimento reutilizáveis. Cada Snippet é revisado e aprovado por um administrador antes de ser publicado e, depois de aprovado, alimenta o Virtual Service Agent e as recomendações de solução. O histórico de chamados se torna uma fonte de conhecimento, e não um arquivo estático: é isso que mantém o autoatendimento e o VSA eficazes à medida que o ambiente muda.

A gestão do backlog deve fazer parte das operações normais de serviço, e não ser um exercício ocasional de recuperação. Uma revisão semanal pode identificar chamados envelhecidos, riscos de SLA, solicitações recorrentes e mudanças no volume de entrada antes que se tornem um problema operacional maior.
A revisão também deve examinar por que os chamados continuam abertos. Um backlog crescente pode indicar capacidade insuficiente, encaminhamento ineficiente, incidentes recorrentes não resolvidos, excesso de etapas de aprovação ou demanda que poderia ser atendida pelo autoatendimento.
Uma fila de chamados saudável não é necessariamente uma fila vazia. O objetivo é um backlog que se mantenha dentro da capacidade da equipe, com responsáveis claros, priorização adequada e tempos de resolução previsíveis.
Comece uma avaliação gratuita de 30 dias do InvGate Service Management para ver como a automação de fluxos de trabalho, a análise de dados, o autoatendimento e a IA podem apoiar a gestão do backlog.
Conclusão
Gerenciar e reduzir o backlog de chamados é fundamental para manter um alto nível de satisfação dos clientes e garantir operações tranquilas na sua equipe de suporte. Ao entender o que é o backlog de chamados, por que é importante acompanhá-lo e quais fatores o afetam, as equipes de suporte podem tomar medidas proativas para monitorar e reduzir seu backlog.
Lembre-se: um backlog de TI bem gerenciado é sinal de um sistema de suporte ao cliente saudável e eficiente.
Adotar uma abordagem proativa com ferramentas de ITSM (Gerenciamento de Serviços de TI) como o InvGate Service Management ajuda a evitar que o backlog saia do controle. Com a combinação certa de estratégia, automação e IA, as equipes de TI conseguem resolver chamados com mais eficiência e oferecer um suporte melhor.
Quer conhecer o InvGate Service Management na prática? Fale com a equipe de Vendas.
Não necessariamente. A idade é um dos fatores, mas a prioridade também deve refletir o impacto no negócio, a urgência, o risco de SLA, as dependências e o esforço necessário para resolver a solicitação. Trabalhar estritamente em ordem cronológica pode deixar problemas de alto impacto esperando atrás de chamados mais antigos e de baixa prioridade.
Observe o tamanho do backlog junto com a idade dos chamados, o volume de entrada, a capacidade de resolução e o desempenho do SLA. Um backlog estável, que se mantém dentro da capacidade da equipe, pode ser saudável. Um backlog que cresce de forma constante, acumula chamados cada vez mais antigos ou provoca violações de SLA indica um problema de capacidade ou de processo.
Não automaticamente. Defina uma política clara para chamados que dependem do cliente, incluindo intervalos de acompanhamento, notificações e o momento em que uma solicitação pode ser fechada por inatividade. Aplique as mesmas regras de forma consistente para que o fechamento não se torne uma forma de reduzir artificialmente os números do backlog.
Trate a situação como um problema de capacidade ou de demanda, e não apenas como uma questão de acelerar o ritmo de fechamento. Compare o volume de entrada com a capacidade de resolução, identifique as categorias que geram demanda desproporcional e determine quais solicitações podem ser automatizadas, redirecionadas para o autoatendimento ou resolvidas na origem.
Procure incidentes repetidos com um sintoma, serviço, configuração ou causa de fundo em comum. Se o mesmo problema continua gerando chamados depois que os incidentes individuais são resolvidos, investigar a causa raiz pode ter um efeito maior sobre o volume do backlog do que processar cada chamado separadamente.
Some os chamados abertos no início do período aos chamados novos recebidos nesse intervalo e subtraia os chamados resolvidos: backlog = chamados abertos no início do período + chamados novos − chamados resolvidos.

